Optimierung von Python
Wieso ist Python “langsam”?
Python ist eine interpretierte Programmiersprache. Dies bedeutet, dass der Code nicht direkt in Maschinencode übersetzt wird, sondern von einem Interpreter zur Laufzeit interpretiert wird. Dies hat den Vorteil, dass der Code plattformunabhängig ist und nicht für jede Plattform neu kompiliert werden muss. Der Nachteil ist jedoch, dass die Ausführungsgeschwindigkeit von Python im Vergleich zu kompilierten Sprachen wie C oder C++ deutlich langsamer ist.
Einige Faktoren, die Python langsamer machen können, sind:
dynamische Typisierung: Python bestimmt die Datentypen von Variablen zur Laufzeit, was im Vergleich zu statisch typisierten Sprachen, bei denen die Datentypen zur Übersetzungszeit bekannt sind, einige Overheads hinzufügt.
Interpretationsaufwand: Der Python-Interpreter muss jeden Befehl analysieren und ausführen, was im Vergleich zu kompiliertem Code einige Overheads hinzufügt.
Speicherverwaltung: Die automatische Speicherverwaltung und die Müllsammlung von Python können einige Overheads verursachen, obwohl dies im Allgemeinen kein wesentlicher Faktor in den meisten Anwendungen ist.
Global Interpreter Lock (GIL): Der GIL ist ein Mechanismus in Python, der verhindert, dass mehrere Threads gleichzeitig Python-Bytecodes ausführen, was die Möglichkeit einschränken kann, die volle Leistungsfähigkeit von Mehrkernprozessoren für bestimmte Arten von parallelisierbaren Aufgaben auszunutzen.
Trotz dieser Faktoren wird Python aufgrund seiner Einfachheit, Lesbarkeit und des umfangreichen Ökosystems von Bibliotheken und Werkzeugen in vielen Bereichen weit verbreitet eingesetzt, darunter Webentwicklung, Datenanalyse, maschinelles Lernen und wissenschaftliches Rechnen.
Deswegen gibt es laufende Bemühungen, die Leistung von Python durch Techniken wie Just-in-Time (JIT)-Kompilierung und alternative Python-Implementierungen wie Cython zu verbessern.
Das Problem am Beispiel einer Monte-Carlo-Simulation zur Berechnung von π
Der Algorithmus
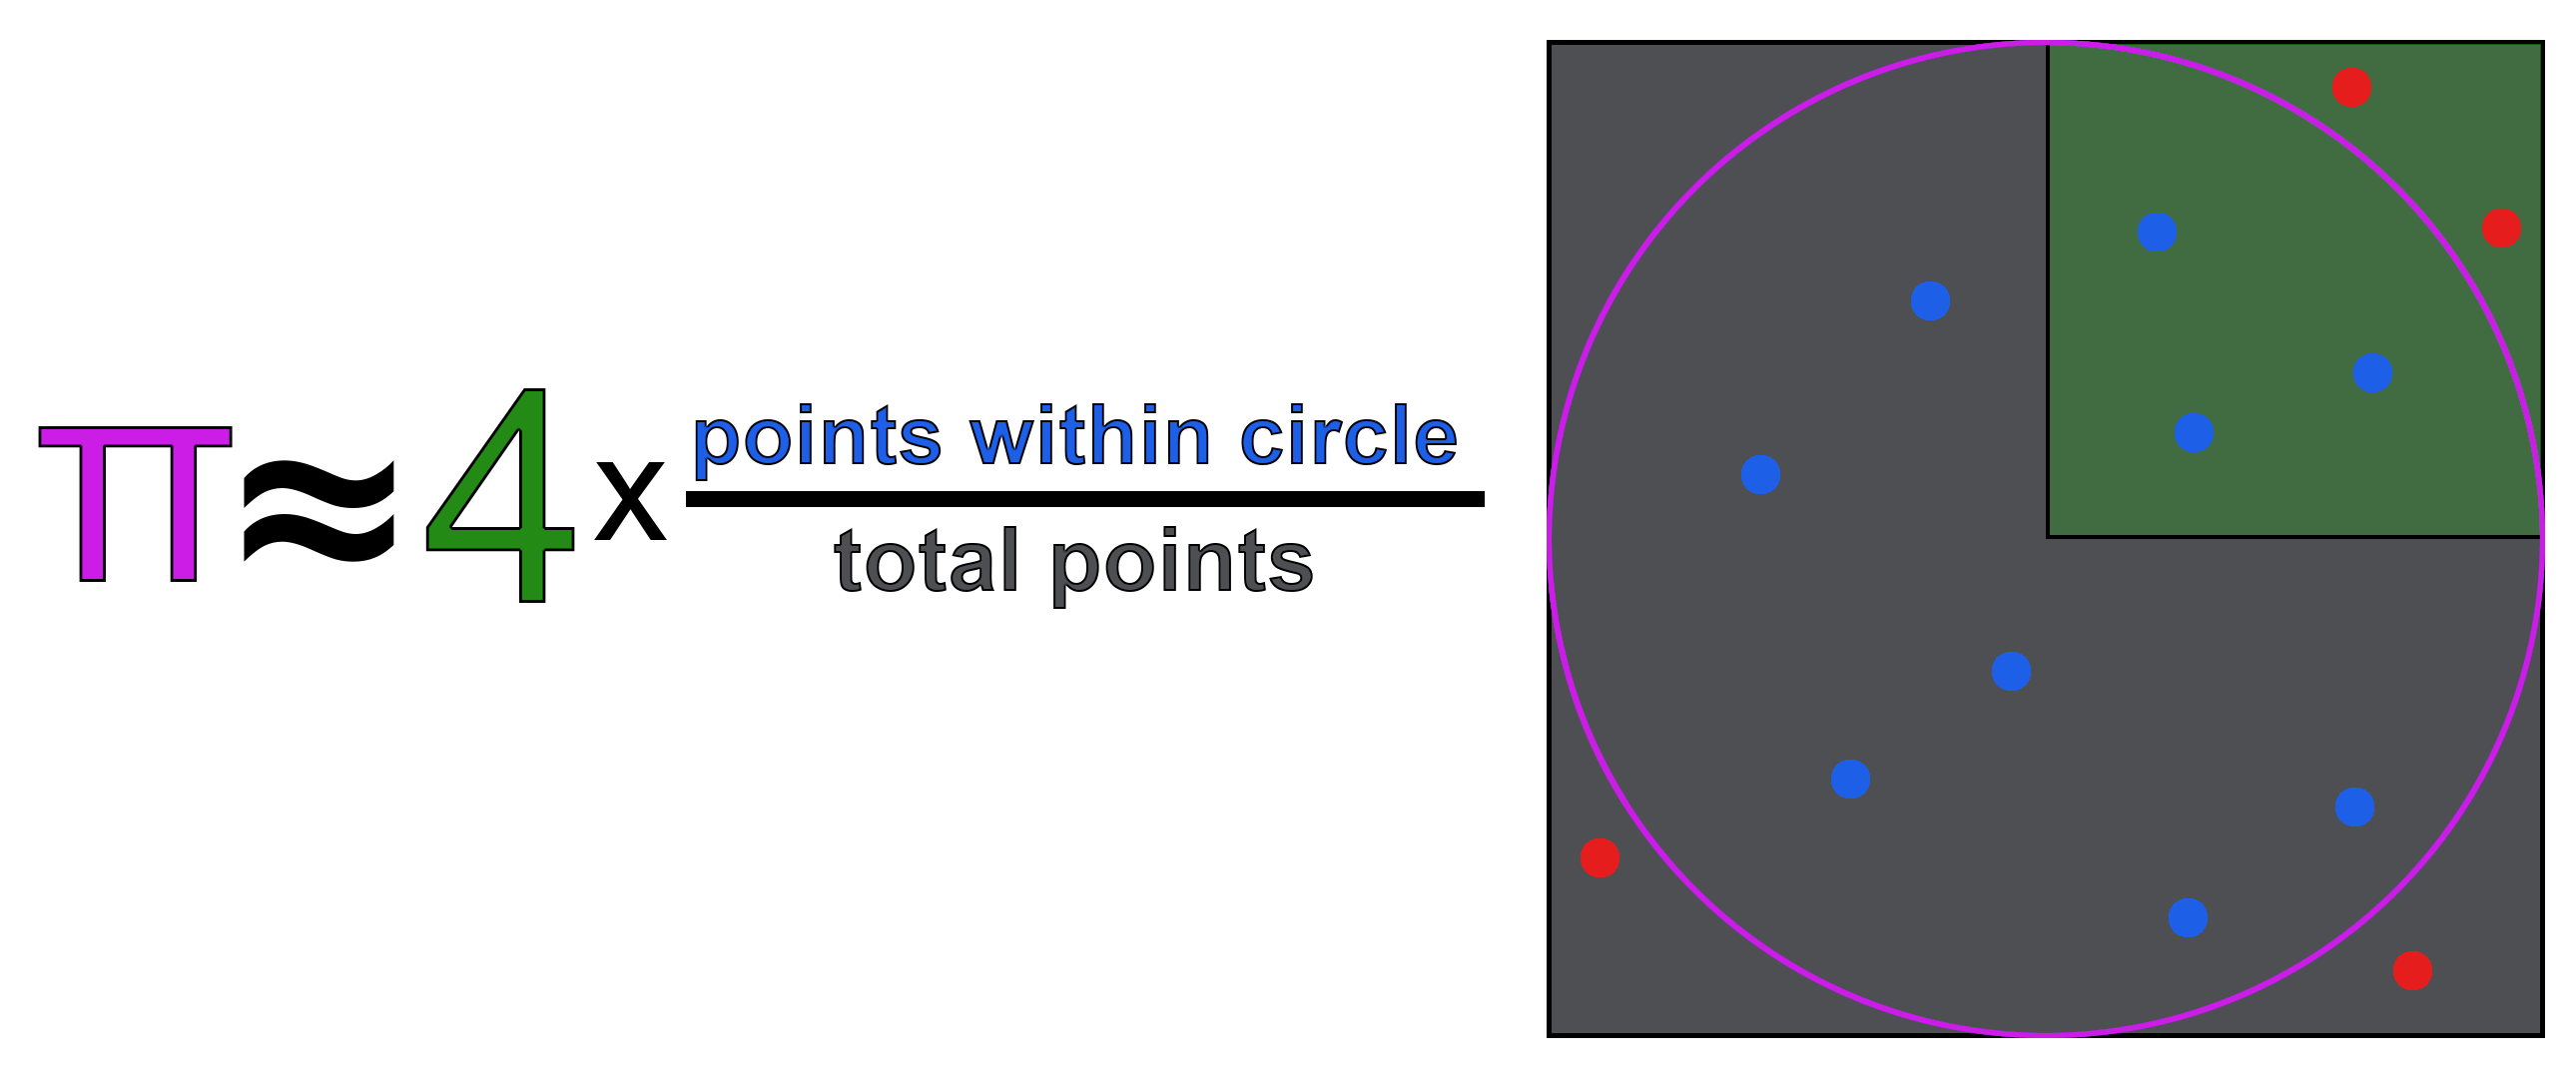
Erstelle ein Quadrat mit einer Seitenlänge von 1 Einheit (oder einer anderen geeigneten Größe).
Zeichne ein Viertelkreis innerhalb des Quadrats ein, dessen Zentrum sich in einer der Ecken des Quadrats befindet.
Generiere eine große Anzahl von zufälligen Punkten (x, y) innerhalb des Quadrats, wobei sowohl x als auch y zwischen 0 und 1 liegen.
Überprüfe für jeden zufälligen Punkt, ob er innerhalb des Viertelkreises liegt, indem du die Bedingung auswertest: x^2 + y^2 <= 1 (unter Verwendung der Gleichung eines Kreises mit Radius 1).
Zähle die Anzahl der Punkte, die innerhalb des Viertelkreises liegen (nennen wir diese Zahl
inside_points).Zähle die Gesamtanzahl der generierten zufälligen Punkte (nennen wir diese Zahl
total_points).Das Verhältnis von
inside_pointszutotal_pointssollte π/4 annähern, da die Fläche des Viertelkreises π/4 beträgt und die Fläche des Quadrats 1 ist.Daher kann π geschätzt werden als: π ≈ 4 * (inside_points / total_points)
Je mehr zufällige Punkte generiert werden, desto besser wird die Annäherung sein. Die Genauigkeit des Ergebnisses hängt von der Anzahl der Punkte ab, die in der Simulation verwendet werden.
Ausgangscode
import random
import time
from math import pi

def monte_carlo_pi(total_points):
    inside_circle: int = 0
    for _ in range(total_points):
        x = random.uniform(-1, 1)
        y = random.uniform(-1, 1)
        if x**2 + y**2 <= 1:
            inside_circle += 1
    pi_estimate = 4 * inside_circle / total_points
    return pi_estimate

total_points: int = 10000000
start_time = time.time()
estimated_pi = monte_carlo_pi(total_points)
end_time = time.time()

print(f"Actural value of π: {pi}")
print(f"Estimated value of π: {estimated_pi}")
print(f"Execution time: {end_time - start_time} seconds")
In diesem Beispiel definieren wir eine Funktion monte_carlo_pi, die die Anzahl der Punkte (total_points) als Argument nimmt. Sie generiert eine Anzahl von total_points zufälligen Punkten innerhalb des Einheitsquadrats und zählt, wie viele innerhalb des Viertelkreises liegen. Schließlich berechnet sie die Schätzung von π mithilfe des Verhältnisses von inside_points zu total_points.
Dieser Code ist bewusst einfach und single-threaded, um die Leistungsoptimierung zu demonstrieren. Die Ausführung dieses Beispielcodes auf einer Machine mit einem Ryzen 7 5800X Prozessor resultierte in einer Ausführungszeit von 4.569427728652954 Sekunden für total_points = 10000000.
Die Monte-Carlo-Methode ein probabilistischer Algorithmus und die Genauigkeit des Ergebnisses von der Anzahl der verwendeten zufälligen Punkte abhängig (O(n)). Mit mehr Punkten wird die Schätzung gegen den wahren Wert von π konvergieren, deswege ist es wichtig, die Berechnung so effizient wie möglich zu gestalten.
Lösungen
Generell kann die Performance immer vertikal durch bessere Rechenleistung oder horizontal durch die Verteilung der Last auf mehrere Prozessoren verbessert werden.
Multithreading/ Multiprocessing
In der Regel wird Python-Code in einem einzigen Thread ausgeführt, was bedeutet, dass nur ein Prozessorkern verwendet wird. Durch die Verwendung von Multithreading oder Processing können wir die Berechnung auf mehrere Instanzen verteilen und so die Rechenleistung des Prozessors besser ausnutzen. Dies beeinflusst jedoch stark die Programmarchitektur und sollte von Anfang an berücksichtigt werden.
Unser Monte-Carlo-Beispiel könnte wie folgt in mehrere Prozesse aufgeteilt werden:
import time
import random
from multiprocessing import Process, Queue, cpu_count
from typing import List, Tuple

def monte_carlo_pi_worker(total_points: int, result_queue: Queue):
    inside_circle = 0
    for _ in range(total_points):
        x = random.uniform(-1, 1)
        y = random.uniform(-1, 1)
        if x ** 2 + y ** 2 <= 1:
            inside_circle += 1
    result_queue.put(inside_circle)


def multi_monte_carlo_pi(total_points: int, cores: int) -> float:
    points_per_core = total_points // cores

    # Generate ranges for each core
    ranges: List[Tuple[int, int]] = []
    for core in range(cores):
        if core == cores - 1:
            ranges.append((core * points_per_core, total_points))
        else:
            ranges.append((core * points_per_core, (core + 1) * points_per_core))

    # Start a process for each range
    processes: List[Process] = []
    results: Queue[int] = Queue()
    for r in ranges:
        p = Process(target=monte_carlo_pi_worker, args=(r[1] - r[0], results))
        processes.append(p)
        p.start()

    # Join all processes to ensure they finish before calculating the final result
    for p in processes:
        p.join()

    hits = 0
    for _ in processes:
        hits += results.get()

    return 4 * hits / total_points
    ...

    # Output:
    # Actural value of π: 3.141592653589793
    # Estimated value of π: 3.1414864
    # Execution time: 0.7100329399108887 seconds
Numba (JIT)
Numba ist ein Open Source Just-in-Time (JIT)-Compiler für Python, der es ermöglicht, Python-Code in Maschinencode zu übersetzen, um die Ausführungsgeschwindigkeit zu verbessern. Numba verwendet die LLVM-Bibliothek, um den Python-Code zu kompilieren und optimierten Maschinencode zu erzeugen.
Numba kann verwendet werden, um Funktionen zu dekorieren, die dann zur Laufzeit kompiliert und optimiert werden. Dies würde unseren Ausgangscode wie folgt ändern:
...
from numba import jit

@jit(nopython=True, parallel=True)
def monte_carlo_pi(total_points):
...

# Output:
# Actural value of π: 3.141592653589793
# Estimated value of π: 3.141542
# Execution time: 0.32506370544433594 seconds
Das Attribut nopython=True gibt an, dass Numba den Code so optimieren soll, dass er ohne die Verwendung von Python-Objekten auskommt. Das Attribut parallel=True gibt an, dass Numba den Code so optimieren soll, dass er parallel ausgeführt werden kann, wenn möglich.
Nur durch diesen einfachen Schritt konnten wir die Ausführungszeit auf 0.32506370544433594 Sekunden reduzieren, was einer fast 14-fachen Verbesserung entspricht. Dies zeigt die Leistungsfähigkeit von Numba bei der Optimierung von Python-Code.
Dieser Gewinn ist aber nicht immer umsonst. Es gibt Ausnahmen, welche von Numba nicht kompiliert werden können (z.B. Funktionen, die Generatoren verwenden). Ebenfalls muss man bedenken, dass bei größeren Projekten die Kompilierungszeit, welche ja zur Laufzeit stattfindet, sehr lang werden kann.
Cython
Cython ist eine statische Compiler-Technologie, die es ermöglicht, Python-Code in C-Code zu übersetzen und als Python-Erweiterung zu kompilieren. Cython erfordert die Verwendung einer speziellen Datei mit der Endung .pyx, die den Python-Code enthält, der in C-Code übersetzt werden soll.
Unser Ausgangscode würde in Cython wie folgt aussehen:
# monte_carlo_pi.pyx
import cython
import random

@cython.boundscheck(False)
@cython.wraparound(False)
def cy_monte_carlo_pi(unsigned long long num_points):
    cdef unsigned long long inside_circle = 0
    cdef double x, y
    for _ in range(num_points):
        x = random.uniform(-1, 1)
        y = random.uniform(-1, 1)
        if x**2 + y**2 <= 1:
            inside_circle += 1
    return 4 * inside_circle / num_points

# setup.py
from setuptools import setup
from Cython.Build import cythonize

setup(
    ext_modules = cythonize("monte_carlo_pi.pyx")
)

# main.py
from monte_carlo_pi import cy_monte_carlo_pi
import time
from math import pi

total_points = 10000000
start_time = time.time()
estimated_pi = monte_carlo_pi(total_points)
end_time = time.time()
...

# Output:
# Actural value of π: 3.141592653589793
# Estimated value of π: 3.1417992
# Execution time: 2.978184938430786 seconds
Cython ist mit ein wenig Aufwand verbunden. Es erfordert die Erstellung einer speziellen Datei mit der Endung .pyx, die den Python-Code enthält, der in C-Code übersetzt werden soll.
In dieser wird eine Mischung von Python- und C-Syntax verwendet, Typen können hier wie in C explizit angegeben werden, dies ist jedoch nicht zwingend erforderlich.
Die Dekoratoren @cython.boundscheck(False) und @cython.wraparound(False) werden verwendet, um die Überprüfung von Arraygrenzen zu deaktivieren, was die Leistung verbessern kann, wenn wir sicher sind, dass die Indizes innerhalb der Grenzen liegen.
Anschließend muss ein setup.py-Skript erstellt werden, um die Übersetzung zu konfigurieren und die C-Erweiterung zu erstellen.
Das Ausführen unseres Ausgangscodes mit Cython ergab eine Ausführungszeit von 2.978184938430786 Sekunden. Dies ist eine Verbesserung gegenüber dem ursprünglichen Code, jedoch nicht so signifikant wie bei Numba und mit mehr Aufwand verbunden.
Mypyc
Mypyc ist ebenfalls ein statischer Compiler für Python. Der Vorteil gegenüber Cython ist jedoch, dass man keine speziellen Dateien oder Dekoratoren benötigt und somit keine neue Syntax lernen muss. Mypyc kann direkt auf vorhandenen Python-Code angewendet werden, ohne dass Änderungen am Code erforderlich sind. Die einzige Vorraussetzung ist, dass der Code mit Typen annotiert ist und sich an diese hält.
Somit ändert sich an unserem Ausgangscode nichts. Beim Ausführen des Codes mit Mypyc erhielten wir eine Ausführungszeit von 4.500236511230469 Sekunden. Leider hat Mypyc in diesem Fall keine Verbesserung gebracht. Jedoch ist dies nicht immer der Fall und hängt von der Art des Codes ab.
Um trotzdem die Fähigkeit von Mypyc zu demonstrieren, können wir uns den folgenden Code zur Berechnung der Fibonacci-Zahlenfolge ansehen:
def fib(n: int) -> int:
    if n <= 1:
        return n
    else:
        return fib(n - 2) + fib(n - 1)

start_time = time.time()
print(fib(38))
end_time = time.time()
print(f"Execution time: {end_time - start_time} seconds")
Die normale Ausführungszeit dieses Codes beträgt 4.871086835861206 Sekunden. Nach der Anwendung von Mypyc beträgt die Ausführungszeit 0.45527029037475586 Sekunden. Dies zeigt, dass Mypyc in einigen Fällen eine nachteillose Verbesserung der Ausführungsgeschwindigkeit bringen kann. Leider hat dies in 3 Versuchen (Monte-Carlo, Fakultät, Liste von Zahlen Quadrieren und Addieren) bei uns nicht funktioniert.
Fazit
Es gibt mehrere Möglichkeiten, die Leistung von Python-Code zu verbessern. Jede dieser Techniken hat ihre Vor- und Nachteile und kann je nach Anwendungsfall unterschiedlich geeignet sein. Numba bietet eine einfache Möglichkeit, die Leistung von Python-Code zu verbessern, indem es diesen zur Laufzeit kompiliert und optimiert. Cython erfordert mehr Aufwand, bietet jedoch mehr Kontrolle und Flexibilität bei der Optimierung von Python-Code. Mypyc ist eine weitere Option, die jedoch von der Art des Codes abhängt und nicht immer eine Verbesserung der Leistung bringt.
Es ist wichtig zu beachten, dass die Optimierung der Leistung von Python-Code oft mit einem Kompromiss zwischen Lesbarkeit, Wartbarkeit und Leistung einhergeht. Es ist ratsam, die Leistungsoptimierung nur dort vorzunehmen, wo sie wirklich notwendig ist und die Lesbarkeit des Codes nicht beeinträchtigt wird.