1. Erstellen einer Datenbank in MongoDB
1.1. Einleitung
Obwohl es sich bei relationalen Datenbanken aktuell noch um den „Quasi-Standard“ handelt, erfreuen sich NoSQL-Datenbanken immer größer werdender Beliebtheit. Das wohl bekannteste NoSQL-Datenbankmanagementsystem trägt den Namen MongoDB. Dieses DBMS kommt auch in diesem Projekt zum Einsatz.
Wir haben uns im Rahmen des DVA-Praktikums dazu entschlossen, ein Projekt zu verwirklichen, in dem es um die Überführung einer SQL-Datenbank in eine NoSQL-Datenbank geht. Als Grundlage für dieses Projekt verwenden wir eine relationale Datenbank, die wir im Rahmen der Veranstaltung „Datenbanken“ im dritten Semester erstellt haben.
Bei dem ursprünglichen Projekt ging es um das Anlegen einer Datenbank, die alle Daten zu diversen Radrennen enthält, welche an unterschiedlichen Orten, an mehreren Tagen und mit mehreren Teilnehmer:innen veranstaltet werden bzw. veranstaltet worden sind. In den Tabellen der Datenbank werden neben Daten zur Strecke wie beispielsweise Datum, Startort, Zielort und Distanz, auch Daten zu den Athlet:innen, deren verwendeter Fahrräder sowie deren Teams, gespeichert.
Bemerkung
Wir setzen für das Verständnis dieser Dokumentation voraus, dass Sie bereits über erste Erfahrungen in SQL und JavaScript verfügen und in der Lage sind einfache SQL-Statements zu lesen und zu verstehen!
Bemerkung
Wir Sie unsere konkrete Datenbank starten und verwenden, entnehmen Sie bitte der README im entsprechenden Verzeichnis.
1.2. Schema-Redefinition
Unsere verwendete Datenbank (Straßenradrennen) war im relationalen Schema, entsprechend den Normalformen. Wie in der Einleitung bereits kurz erwähnt, wurde die ursprüngliche Datenbank nach dem Schema normalisiert, das uns im Rahmen der „Datenbanken“-Vorlesung beigebracht wurde.
In dokumentbasierten Datenbanken besteht die Möglichkeit, ein flexibles Schema zu nutzen, womit die Anzahl der Join-Operationen erheblich verringert werden kann.
In diesem Fall ist es ratsam, das Schema unabhängig von den zu erwarteten Anfragen zu erstellen. Das ursprüngliche Schema der relationalen Datenbanken sah folgendermaßen aus:
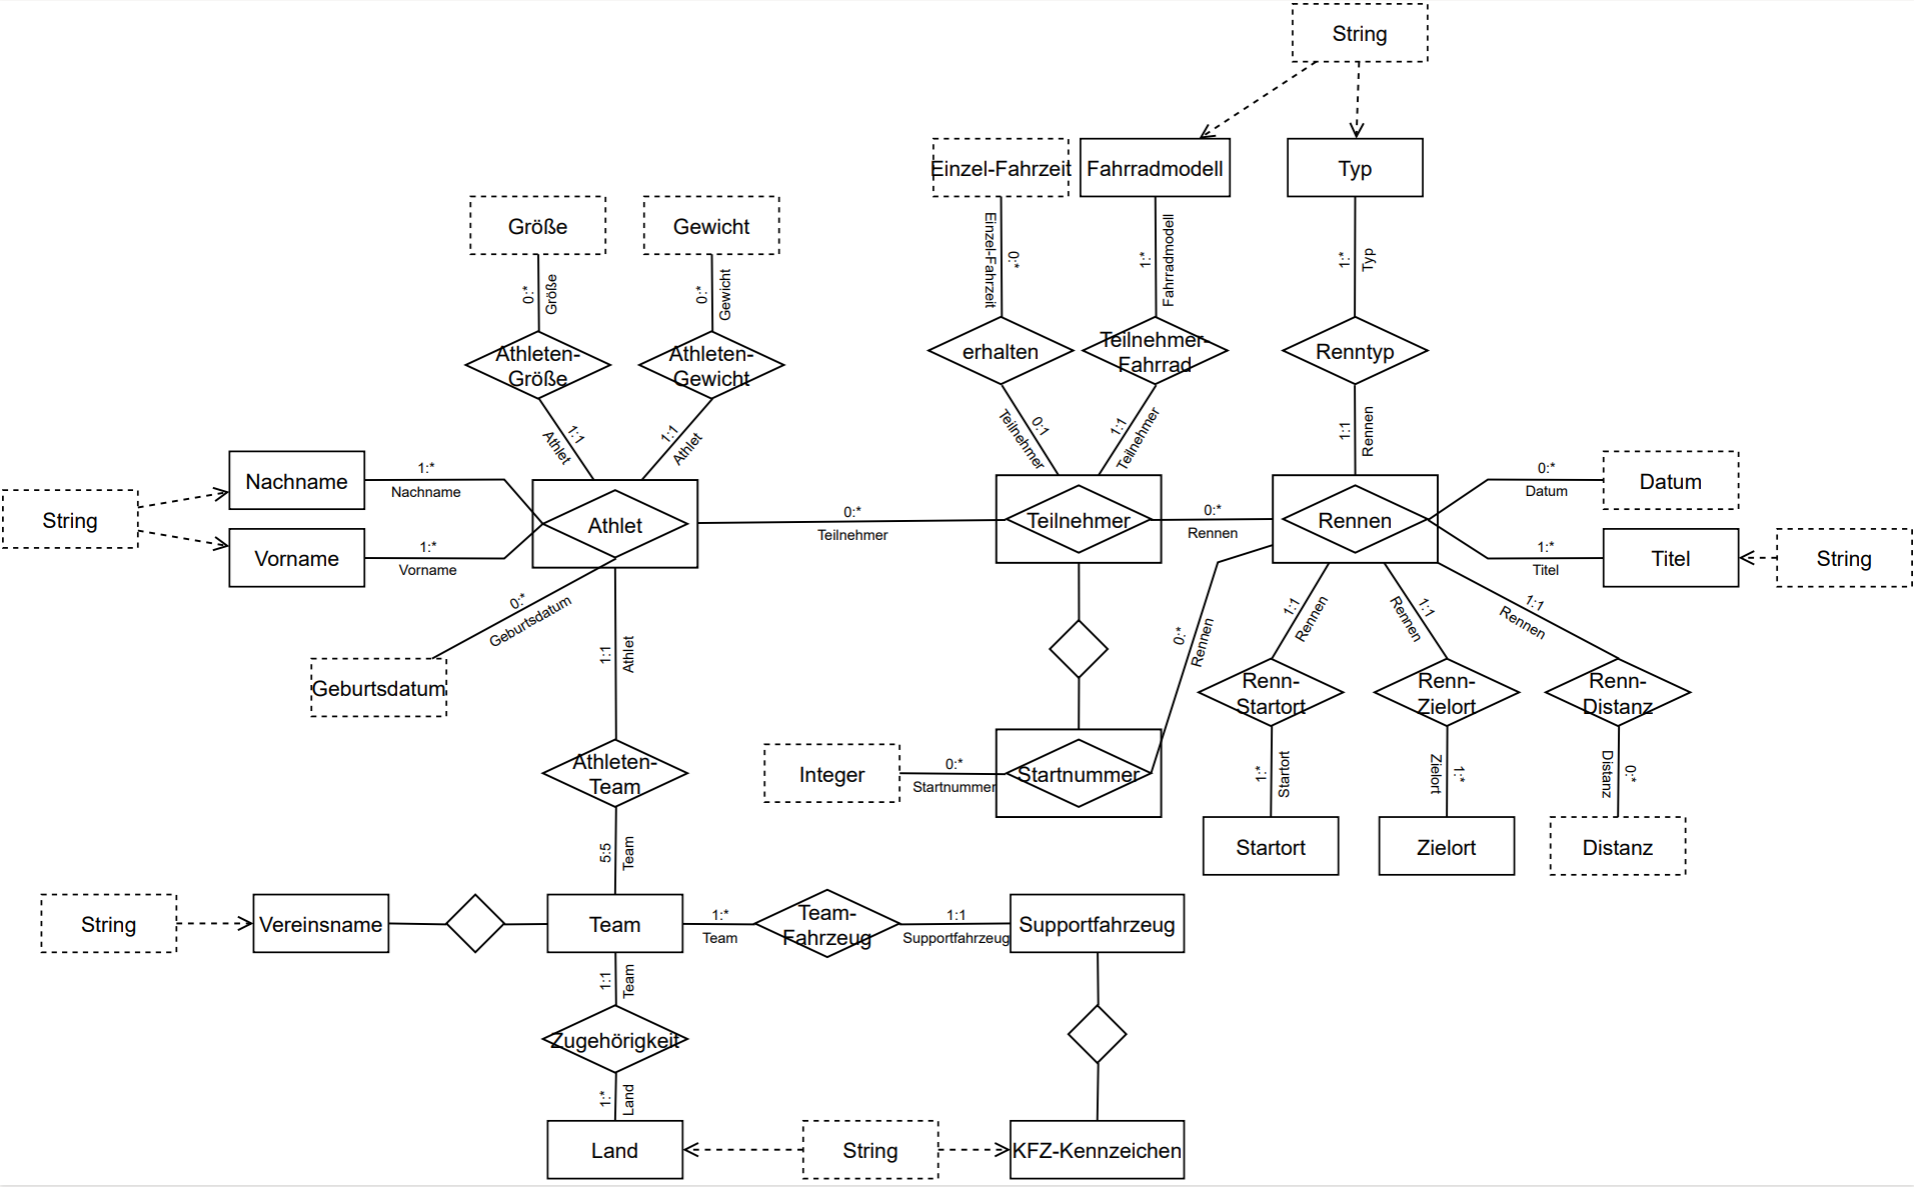
Abb. 1: Schema der relationalen Datenbank
Auf Grundlage unser selbst entwickelten Abfragen an die relationale Datenbank, trafen wir die Entscheidung, das neue Schema auf ein drei Kern-Relationen zusammenzuführen. Es wurden also Dokumente ineinander gebaut. MongoDB nutzt hier den Ausdruck nested documents. Die nachfolgende Abbildung soll zeigen, welche Tabellen und damit Dokumente zusammengeführt wurden.
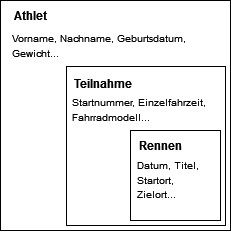
Abb. 2: Schema der dokumentenbasierten Datenbank
Ein bedeutender Vorteil dieses Schemas ist, dass nun erheblich weniger Joins notwendig sind. Die Statements, die wir nun mit NoSQL schreiben, sind in unseren Augen wesentlich leserlicher und verständlicher. Jedoch entsteht etwas Overhead, da zunächst Code geschrieben werden muss, der die Tabellen zusammenführt.
1.3. Erstellen der Collections in MongoDB
In diesem Abschnitt wollen wir darauf eingehen, wie die Redefinition unseres Schemas auf Code Ebene aussieht. Dies lässt sich grob in zwei Teile aufteilen. Das Importieren der Daten in die einzelnen Collections und das anschließende nesten der Tabellen athlet, teilnehmer und rennen.
Damit überhaupt mit der Datenbank gearbeitet werden kann, müssen wir sie nach dem Erstellen mit Daten füllen. Hierzu verwenden wir ein File data.js indem alle Daten für die verschiedenen Tabellen zu sehen sind. Innerhalb dieses Files definieren wir verschiedene Konstanten, die die Queries darstellen sollen. Im folgenden sind die unterschiedlichen Konstanten aufgelistet:
 export const teamsQuery = [{ ... }, { ... }, ...];
 export const athletsQuery = [{ ... }, { ... }, ...];
 export const rennenQuery = [{ ... }, { ... }, ...];
 export const supportfahrzeugeQuery = [{ ... }, { ... }, ...];
 export const teilnehmerQuery = [{ ... }, { ... }, ...];
Wie die Daten dieser Konstanten konkret aussehen, können sie dem nachfolgenden Codeblock entnehmen. Exemplarisch wurde hier ein Ausschnitt der athletQuery verwendet:
 export const athletsQuery = [
     {
         nachname: "Dai",
         vorname: "Deng",
         geburtsdatum: "1995-12-09",
         groesse: 190,
         gewicht: 81,
         team: "Vagram",
     },
     {
         nachname: "Hwang",
         vorname: "Kang",
         geburtsdatum: "1998-05-21",
         groesse: 177,
         gewicht: 81,
         team: "Vagram",
     },
     {
         nachname: "Ming",
         vorname: "Fang",
         geburtsdatum: "1995-06-29",
         groesse: 169,
         gewicht: 78,
         team: "Vagram",
     },
     {
         ...
         ...
     },
     ...
 ]
Wir verfügen nun über Daten. Der nächste logische Schritt ist es, die Datensätze in die Datenbank einzulesen. Hierfür könnten wir uns für jede Tabelle oder jedes Dokument eine kleine Methode bauen, die die jeweilige Konstante mit den Daten nimmt und diese dann in die Datenbank schreibt. Solch eine Methode könnte wie folgt aussehen.
 async function createAthlet(athletsQueryArray) {
     // set index and add uniqueness constraint
     db.collection("athlet").createIndex(
         { nachname: 1, vorname: 1, geburtsdatum: 1 },
         { unique: true }
     );
     await db.collection("athlet").insertMany(athletsQueryArray);
 }
In der letzten Zeile der Methode fügen wir in das Dokument athlet die Daten ein, die wir der Methode über den Parameter athletsQueryArray mitgeben. Der erste Teil der Methode definiert einen Primärschlüssel für dieses Dokument.
Nun verfügen wir über eine Datenbank, die auch Daten enthält. Es bleibt der letzte Schritt übrig, der gleichzeitig der komplexeste ist. Wir wollen die Dokumente athlet, teilnehmer und rennen zu einem verschachtelteten Dokument zusammenbauen. Um dies zu ermöglichen, definieren wir uns eine Methode, in der wir die Logik in zwei Teile aufteilen.
Das Rennen in das Dokument teilnehmer überführen
Das Dokument teilnehmer in das Dokument athlet überführen
Um diesen Zusammenhang besser zu verstehen, werfen Sie nochmal einen Blick auf Abbildung 2.
Wir könnten unsere Methode also wie folgt aufteilen.
 async function createCombinedCollection() {
     await addRennenToTeilnehmer();
     await addTeilnahmenToAthlete();
     await db.collection("rennen").drop();
     await db.collection("teilnehmer").drop();
 }
Hier definieren wir eine Methode createCombinedCollection(). Wie oben beschrieben, teilen wir diese auf in addRennenToTeilnehmer() und addRennenToTeilnehmer(). Nachdem die ersten beiden Zeilen in der Methode ausgeführt wurden leben die Dokumente rennen und teilnehmer in dem Dokument athlet. Demnach folgen zwei Zeilen, mit denen die beiden Dokumente rennen und teilnehmer als einzelne Dokumente entfernt werden.
Sehen wir uns exemplarisch die Methode addRennenToTeilnehmer() an.
 async function addRennenToTeilnehmer() {
   let result = await db
     .collection("teilnehmer")
     .aggregate([
       {
         $lookup: {
           from: "rennen",
           let: {
             rennen_datum: "$rennen_datum",
             rennen_titel: "$rennen_titel",
           },
           pipeline: [
             {
               $match: {
                 $expr: {
                   $and: [
                     { $eq: ["$datum", "$$rennen_datum"] },
                     { $eq: ["$titel", "$$rennen_titel"] },
                   ],
                 },
               },
             },
           ],
           as: "rennen",
         },
       },
     ])
     .toArray();

   for (const teilnehmerDocument of result) {
     const { rennen_datum, rennen_titel, rennen } = teilnehmerDocument;

     await db
       .collection("teilnehmer")
       .updateOne({ rennen_datum, rennen_titel }, { $set: { rennen: rennen } });
   }
 }
In dieser Methode wird das Dokument teilnehmer um ein Feld namnens rennen erweitert. Dort stehen alle Einträge, die zuvor im Dokument rennen standen.
Sie können die Methode addTeilnahmenToAthlete() analog betrachten.
Um die gerade besprochenen Punkte besser einordnen zu können, sei hier noch einmal gezeigt, was beim Ausführen von npm run create konkret passiert.
 async function run() {
     try {
         // Datenbankobjekt erstellen
         db = client.db("strassenrennen");
         // Die Dokumente befüllen
         await createTeams(teamsQuery);
         await createAthlet(athletsQuery);
         await createTeilnehmer(teilnehmerQuery);
         await createSupportFahrzeuge(supportfahrzeugeQuery);
         await createRennen(rennenQuery);
         // Das zusammengeführte Dokument erstellen (athlet, teilnehmer, rennne)
         // Die übrigen Dokumente wieder löschen
         await createCombinedCollection();
     } finally {
         await client.close();
     }
 }
Es wir das Objekt db erstellt, dann die Datenbank mit Hilfe der create-Methoden befüllt und anschließend die kombinierte Collection mittels der Methode createCombinedCollection() erstellt.
1.4. Update von Datensätzen in Tabellen
Dieser Abschnitt beschreibt die Unterschiede zwischen der Befüllung einer Tabelle mit Daten in SQL und der Befüllung einer Tabelle mit Daten in NoSQL.
Beispiel für das Einfügen eines Datensatzes in SQL:
 insert
 into   athlet
     (nachname, vorname, geburtsdatum, groesse, gewicht, team)
 values ('Dai', 'Deng', TO_DATE('1995-12-09', 'yyyy-mm-dd'), 190, 81, 'Vagram')
Beispiel für das Einfügen eines Datensatzes in NoSQL:
 async function createAthlet(athletsQueryArray) {
     // set index and add uniqueness constraint
     db.collection("athlet").createIndex(
         { nachname: 1, vorname: 1, geburtsdatum: 1 },
         { unique: true }
     );
         await db.collection("athlet").insertMany(athletsQueryArray);
 }
1.5. Read Abfragen
Dieser Abschnitt beschreibt die Unterschiede zwischen dem Lesen von Daten aus einer SQL-Tabelle und dem Lesen einer Tabelle in NoSQL.
Beispiel für das Abrufen von Daten aus einer Tabelle in SQL: Hier am Beispiel: Zeige Athleten, die bisher an keinem Rennen teilgenommen haben
 SELECT a.vorname, a.nachname
 FROM athlet a
 WHERE NOT EXISTS (
     SELECT 1
     FROM teilnehmer t
     WHERE a.vorname = t.athlet_v_name AND a.nachname = t.athlet_n_name AND a.geburtsdatum = t.athlet_g_datum
 );
Beispiel für das Abrufen von Daten aus einer Tabelle in NoSQL: Hier am Beispiel: Zeige Athleten, die bisher an keinem Rennen teilgenommen haben
 async function athletesWithoutParticipations() {
     console.log("#2: Athlet, welcher bisher an keinem Rennen teilgenommen hat");
     let result = await db
         .collection("athlet")
         .aggregate([
         {
             $match: {
             teilnahmen: { $eq: [] }, // Filter out documents where "teilnehmer" array is empty
             },
         },
         {
             $project: {
             vorname: "$vorname",
             nachname: "$nachname",
             },
         },
         ])
         .toArray();

     await console.log(result);
 }
Wie Sie am Beispiel sehen können, ist NoSQL einfach zu erlernen und relativ selbstredend.
- Nutzung der aggregate Funktion, um mehrere Abfrageschritte in Form einer Pipeline zu kombinieren: [AGGREGATE_FUNCTION]
$match, um die Daten auf Bedingungen zu filtern (ähnlich WHERE-Teil in relationaler Abfrage) [MONGODB_MATCH]
$project, um die Felder auszuwählen, die im Output angezeigt werden sollen (ähnlich dem Auswählen spezieller Spaltennamen in relationaler DB) [MONGODB_PROJECT]
$group, um nach einem Schlüssel zu gruppieren (ähnlich GROUP BY in SQL) [MONGODB_GROUP]
alternativ: Chainen von Abfrage-Funktionen wie find() (statt $match), sort(), project()
nach einigem Einlesen sehr einfach, die Abfragen zu übertragen aus unseren SQL-Vorlagen
1.6. Update Statements
Dieser Abschnitt beschreibt die Unterschiede beim Updaten von Tabellen-Inhalten zwischen SQL und NoSQL. Um ein besseres Verständnis dafür zu bekommen, wie eine Dartenbank mit NoSQL aktualisiert wird, sei hier zunächst ein Beispiel in klassischem SQL gezeigt.
 // Disqualifiziere gesamtes Team Vagram
 UPDATE teilnehmer t
 SET einzel_fahrzeit = NULL
 WHERE EXISTS (
     SELECT 1
     FROM athlet a
     WHERE a.team = 'Vagram' AND a.vorname = t.athlet_v_name AND a.nachname = t.athlet_n_name AND a.geburtsdatum = t.athlet_g_datum
 );
Mit diesem Statement werden alle Einträge in der Tabelle teilnehmer verändert, die den Teamnamen Vagram haben. Hier wird die Einzelfahrzeit auf null gesetzt. Im Kontext eines Straßenradrennens kann dies als Disqualifizierung aller Teilnehmer eines ganzen Teams interpretiert werden.
Möchte man nun dieses SQl-Statement nach NoSQL migrieren, dann bieten sich hier im Grunde zwei Möglichkeiten an. NoSQl sieht hier 2 Methoden vor.
- updateOne() [UPDATE_ONE]
Diese Methode aktualisiert genau einen Eintrag in einem MongoDB Dokument
Hierzu nimmt er das erste, für das der angegebene Filter passt und wendet das Schlüsselwort SET darauf an
- updateMany()[UPDATE_Many]
Diese Methode aktualisiert alle Einträge in einem MongoDB Dokument
Hierzu wird der angegebene Filter auf alle Elemente im Dokument angewendet, für die er zutrifft
Der einzige Unterschied zwischen den beiden Methoden beschränkt sich auf die Anzahl der Elemente, die mit diesem Statement verändert werden. Der nachfolgende Codeblock soll die Methode updateMany() nochmal genauer zeigen.
 let result = await db.collection('athlet')
     .updateMany(
         //query
         {team: teamName},
         //update
         {$set: {'teilnahmen.$[].einzel_fahrzeit': null}},
         //options
         {}
     )
Mit dem Aufruf db.collection(‚athlet‘) wird zunächst auf der Datenbank das Dokument mit dem Namen athlet gesucht. Auf diesem Objekt können jetzt verschiedene Operationen ausgeführt werden. Im obigen Beispiel soll es die Methode updateMany() sein. Die Methode nimmt zwei Parameter entgegen. Der erste ist der Filter, mit dem die Elemente identifiziert werden, die aktualisiert werden sollen. Der zweite Parameter führt dann über das Schlüsselwort SET die Aktualisierung durch. Mit dem dritten Parameter können noch Optionen angegeben werden, die aber nicht zwingend nötig sind.
1.7. Delete Statements
Dieser Abschnitt beschreibt die Unterschiede zwischen dem Löschen eines Datensatzes in SQL und dem Löschen eines Datensatzes in NoSQL. Auch hier wollen wir zuerst eine klassisches SQL Statement betrachten um es dann in ein NoSQL Satement übersetzten zu können. Betrachten wir also folgendes SQL Statement.
SELECT * FROM teilnehmer WHERE athlet_n_name='Samuelson';
Hier werden alle Einträge in der Tabelle teilnehmer betrachtet und dann entschieden ob das Feld name gleich dem angegeben String Samuelson ist. Stimmt eine Query für einen Eintrag, so wird dieser aus der Tabelle entfernt.
Um diese Funktionalität auch in ein NoSQL zu nutzen, können wir uns eine generische Methode erstellen, die uns unter Angabe eines Vornamen, Nachname und Geburtsdatum einen Athleten aus der Datenbank löscht. Betrachten wir dies wieder im Kontext Straßenradrennen, so kann dies als Disqualifizierung eines einzelnen Athleten betrachtet werden. Nachfolgenden ist der Aufruf der generischen Methode zum Disqualifizieren eines Athleten zu sehen.
await disqualifyAthlete('Dai', 'Deng','1995-12-09');
Nun wollen wir uns die Methode noch etwas genauer ansehen. Analog zu den update-Methoden in NoSQL gibt es auch Methoden zum Löschen von Einträgen. NoSQL unterscheidet auch hier in zwei Methoden:
- deleteOne() [DELETE_ONE]
Diese Methode entfernt genau ein Eintrag in einem MongoDB Dokument
Hierzu nimmt er das erste, für das der angegebene Filter passt und entfernt es anschließend
- deleteMany() [DELETE_MANY]
Diese Methode entfernt alle Einträge in einem MongoDB Dokument, für das der Filter passt.
Hierzu wird der angegebene Filter auf alle Elemente im Dokument angewendet, für die er zutrifft
Der einzige Unterschied zwischen den beiden Methoden beschränkt sich wieder auf die Anzhal der Elemente, die mit diesem Statement entfernt werden. Die Nachfolgende Funktion enthät den Methodenrumpf unserer oben aufgerufenen Methode. Hier ist auch zu erkennen, wie die Methode deleteMany() verwendet wird.
 // Ein Athlet wird fom Rennen disqualifiziert
 async function disqualifyAthlete(nachname, vorname, geb) {
     console.log('#1: Ein Athlet wird fom Rennen disqualifiziert');
     let result = await db.collection('athlet')
         .deleteMany(
             //query
             {nachname: nachname, vorname:  vorname, geburtsdatum: geb}
         )
     }
 }
Wie bei den update-Methoden wir mit dem Aufruf db.collection(‚athlet‘) zunächst auf der Datenbank das Dokument mit dem namen athlet gesucht. Auf diesem Objekt können jetzt verschiedenen Operationen ausgeführt werden. Im obrigen Beispiel soll es die Methode deleteMany() sein. Die Methode nimmt zwei Parameter. Der erste ist der Filter, mit dem die Elemente identifiziert werden, die gelöscht werden sollen. Die Angabe eines weiteren Parameters ist bei dieser Methode nicht nötig. Bei dieser Methode ist es auch möglich eine Exception zu werfen. In manchen Fällen ist es also sinvoll zusätzlich um die Methode noch einen try-catch-block zu bauen, um die Exception zu fangen.
NoSQL hällt auch eine Möglichkeit bereit, mit einem Befehl die ganze Datenbank zu löschen. Hierzu wollen wir uns folgenden Code ansehen:
await db.dropDatabase();
Mit diesem Befehl kann die komplette Datenbank gelöscht werden. Um sie anschhließend wiederverwenden zu können, muss sie mit npm run create wieder neu erstellt und befüllt werden. Man könnte nun dieses Statement in eine separate Methode implementieren, um eine Verwechslung zu vermeiden. Ein Beispiel sehen sie im nachfolgenden Codeblock.
 // drop hole database (clean-up before running create anew)
 async function deleteHoleDatabase() {
     console.log('#2: Die ganze Datenbank löschen');
     await db.dropDatabase();
 }
1.8. SQL oder NoSQL
Prinzipiell kamen wir während diese kurzen Bearbeitungsphase zu folgenden Erkenntnissen:
SQL-Datenbanken eignen sich gut für Anwendungen mit komplexen Abfragen und Transaktionen, während NoSQL-Datenbanken besser für skalierbare Anwendungen mit unstrukturierten Daten geeignet sind.
Nach unseren Erfahrungen ist also der größte Vorteil einer NoSQL-Datenbank die flexible Datenmodellierung. Es lässt sich jedoch nicht pauschal sagen, welches der Systeme besser ist. Es kommt auf die Anwendung an, in der das System eingesetzt werden soll.
1.9. Schlusswort
NoSQL Datenbanken sind in unseren Augen eine gute Alternative zu den klassischen relationalen Datenbanken mit SQL. Sie bieten mehr Flexibilität und Skalierbarkeit. Jedoch muss hier genauer auf Konsistenz geachtet werden. Wenn man bereits mit der Sprache SQL vertraut ist, ist die Einarbeitung in NoSQL nicht sonderlich komplex. Man erkennt viele Gemeinsamkeiten und kann schnell einfache SQL-Statements nach NoSQL migrieren. Je mehr Statements man in NoSQL schreibt, desto schneller werden die Vorteile von NoSQL gegenüber SQL sichtbar. Jedoch kann NoSQL SQL nicht ersetzen, beide Systeme haben ihre Vor- und Nachteile.
Wie oben bereits beschrieben, muss die Datenbank auf die Anwendung angepasst werden.
1.10. Literatur
MongoDB Doku: $match (aggregation) (abgerufen am 1.4.2024): https://www.mongodb.com/docs/manual/reference/operator/aggregation/match/
MongoDB Doku: $match (aggregation) (abgerufen am 01.04.2024): https://www.mongodb.com/docs/manual/reference/method/db.collection.aggregate/
MongoDB Doku: $project (aggregation) (abgerufen am 01.04.2024): https://www.mongodb.com/docs/manual/reference/operator/aggregation/project/
MongoDB Doku: $group (aggregation) (abgerufen am 01.04.2024): https://www.mongodb.com/docs/manual/reference/operator/aggregation/group/
MongoDB Doku: (abgerufen am 01.04.2024): https://www.mongodb.com/docs/manual/core/index-unique/
MongoDB Doku: (abgerufen am 02.04.2024): https://www.mongodb.com/docs/manual/reference/method/db.collection.updateOne/
MongoDB Doku: (abgerufen am 02.04.2024): https://www.mongodb.com/docs/manual/reference/method/db.collection.updateMany/
MongoDB Doku: (abgerufen am 02.04.2024): https://www.mongodb.com/docs/manual/reference/method/db.collection.deleteOne/
MongoDB Doku: (abgerufen am 02.04.2024): https://www.mongodb.com/docs/manual/reference/method/db.collection.deleteMany/