1. 10.04.2025 Containerisierung mit Docker
1.1. Einleitung
In modernen IT-Umgebungen steigt der Bedarf an modularen, skalierbaren und leicht wartbaren Systemen. Klassische monolithische Anwendungen sind schwergewichtig und schwer zu skalieren. Container-Technologien wie Docker ermöglichen es, Anwendungen in einzelne, voneinander entkoppelte Dienste (Microservices) aufzuteilen, die unabhängig voneinander entwickelt, betrieben und skaliert werden können. Docker bietet dabei eine standardisierte Plattform zur Ausführung von Anwendungen in isolierten Umgebungen – sogenannten Containern. Jeder Container enthält alles, was die Anwendung zum Laufen braucht: Code, Laufzeit, Systemtools, Bibliotheken und Konfiguration.
1.2. Grundlagen
1.2.1. Vorteile von Docker
Portabilität: Container laufen identisch auf jeder Plattform, unabhängig vom Hostsystem.
Schneller Aufbau: Neue Instanzen können in Sekunden bereitgestellt werden.
Isolierung: Jeder Container läuft unabhängig – Fehler in einem Dienst beeinflussen andere nicht.
Effizienz: Container teilen sich den Kernel des Hostsystems – geringerer Ressourcenbedarf als virtuelle Maschinen.
Skalierbarkeit: Container können leicht horizontal skaliert und verteilt werden (z. B. über Load Balancer).
1.2.1.1. Unser Versuchsaufbau: Eine containerisierte TODO-Webanwendung
Zur Demonstration des containerbasierten Aufbaus von Microservices wurde eine einfache webbasierte TODO-Anwendung entwickelt. Diese besteht aus fünf logisch getrennten Komponenten, die jeweils in einem eigenen Container ausgeführt werden:
Komponente |
Beschreibung |
|---|---|
Load Balancer |
Verteilt HTTP-Anfragen im Least-Connections-Verfahren auf zwei identische Frontend-Instanzen (NGINX). |
Frontend 1 & 2 |
Zwei identische Benutzeroberflächen, umgesetzt mit Streamlit, erreichbar über Port 80. |
Backend |
Eine REST-API, implementiert mit Flask, die Benutzerdaten und Einträge verarbeitet und verwaltet. |
Redis (DB) |
Key-Value-Store für die Speicherung der Benutzer- und Eintragsdaten inklusive Persistenz per Volume. |
Ziel des Projekts war es, nicht nur eine funktionale Webanwendung zu erstellen, sondern vor allem das Zusammenspiel containerisierter Komponenten zu demonstrieren. Benutzerinteraktionen durchlaufen dabei mehrere Container-Schichten: Vom UI über den Load Balancer bis hin zur persistenten Datenspeicherung in Redis.
1.2.2. Service-Orchestrierung
1.2.2.1. Grundlagen der Service-Orchestrierung
Service-Orchestrierung bietet einen zentralen Mechanismus zur Verwaltung der Serviceinteraktionen und Workflow-Prozesse. Im Gegensatz zur Choreographie, bei der Services unabhängig kommunizieren, gibt es bei der Orchestrierung einen zentralen Controller.
Vorteile: - Zentrale Kontrolle über den Workflow - Vereinfachte Fehlerbehandlung - Bessere Sichtbarkeit des Gesamtprozesses
1.2.2.2. Werkzeuge zur Service-Orchestrierung
Es gibt verschiedene Tools und Frameworks, die bei der Orchestrierung von Microservices helfen:
Kubernetes: Ein Container-Orchestrierungssystem zur Automatisierung der Bereitstellung und Skalierung von Anwendungen.
Apache Camel: Ein Framework zur Implementierung von Enterprise Integration Patterns.
Netflix Conductor: Ein Framework zur Orchestrierung von Microservices-basierten Prozessen.
Docker Compose: Ein Tool zur Definition und Ausführung von Multi-Container-Docker-Anwendungen.
1.2.2.3. Service-Orchestrierung mit Docker Compose
Docker Compose ist ein leistungsstarkes Werkzeug, das die Orchestrierung mehrerer Docker-Container erleichtert. Es ermöglicht die Definition und Verwaltung mehrerer Dienste in einer einzigen YAML-Datei, was die Komplexität der Microservice-Architektur erheblich reduziert.
1.2.2.4. Grundkonzepte von Docker Compose
Docker Compose basiert auf folgenden Kernkomponenten:
Services: Die Container-Anwendungen, die Teil der Gesamtanwendung sind
Networks: Kommunikationskanäle zwischen den Containern
Volumes: Persistente Daten, die auch nach dem Neustart der Container erhalten bleiben
1.2.2.5. Struktur der docker-compose.yml
Die zentrale Konfigurationsdatei für Docker Compose ist die docker-compose.yml. In unserem Projekt ist sie wie folgt strukturiert:
version: '3.9'  # Docker Compose Version

services:
  redis:  # Datenbankservice
    image: redis:alpine
    container_name: redis
    ports:
      - "6379:6379"
    volumes:
      - redis_data:/data

  backend:  # Backend-Service
    build: ./backend
    container_name: backend
    ports:
      - "5000:5000"
    depends_on:
      - redis

  frontend1:  # Erste Frontend-Instanz
    build: ./frontend1
    container_name: frontend1
    depends_on:
      - backend

  frontend2:  # Zweite Frontend-Instanz
    build: ./frontend2
    container_name: frontend2
    depends_on:
      - backend

  loadbalancer:  # Load Balancer für die Frontends
    image: nginx:alpine
    container_name: loadbalancer
    ports:
      - "80:80"
    volumes:
      - ./loadbalancer/default.conf:/etc/nginx/conf.d/default.conf
    depends_on:
      - frontend1
      - frontend2
volumes:
  redis_data:  # Persistenter Speicher für Redis-Daten
1.2.2.6. Schlüsselelemente der Service-Orchestrierung in unserem Projekt
Container-Abhängigkeiten
Docker Compose ermöglicht die Definition von Abhängigkeiten zwischen Services mit der
depends_onAnweisung. In unserem Projekt starten die Frontend-Services erst, nachdem der Backend-Service gestartet ist, und der Backend-Service wartet auf Redis:backend: depends_on: - redis frontend1: depends_on: - backend
Dies stellt sicher, dass Services in der richtigen Reihenfolge gestartet werden.
Load Balancing
Unser Projekt implementiert ein klassisches Load-Balancing-Muster mit zwei Frontend-Instanzen hinter einem Nginx-Load-Balancer:
Der Nginx-Service leitet den Datenverkehr an die Frontend-Services weiter
Die Konfiguration wird über ein gemapptes Volume bereitgestellt
Dies ermöglicht horizontale Skalierung der Frontend-Anwendung
Datenpersistenz
Für die Datenpersistenz nutzen wir Docker Volumes:
volumes:
  redis_data:
Der Redis-Service speichert seine Daten in diesem Volume, wodurch die Daten auch bei Neustarts oder Updates der Container erhalten bleiben.
Netzwerkkommunikation
Docker Compose erstellt automatisch ein gemeinsames Netzwerk für alle definierten Services. Die Services können sich gegenseitig über ihre Service-Namen ansprechen, was die interne Kommunikation vereinfacht:
Der Backend-Service kann Redis über den Hostnamen „redis“ erreichen
Die Frontend-Services können den Backend-Service über den Hostnamen „backend“ erreichen
Der Load Balancer kann die Frontend-Services über ihre Namen „frontend1“ und „frontend2“ erreichen
1.2.2.7. Vorteile der Orchestrierung mit Docker Compose
Einfachheit: Im Vergleich zu komplexeren Orchestrierungslösungen wie Kubernetes ist Docker Compose einfacher zu erlernen und einzusetzen.
Deklarative Konfiguration: Die gesamte Anwendungsinfrastruktur wird in einer einzigen YAML-Datei definiert, was die Versionierung und das Deployment vereinfacht.
Entwicklungsfreundlichkeit: Docker Compose eignet sich hervorragend für Entwicklungs- und Testumgebungen, da es schnell auf- und abgebaut werden kann.
Portabilität: Die Anwendung kann auf jedem System ausgeführt werden, auf dem Docker und Docker Compose installiert sind.
1.2.2.8. Grenzen von Docker compose
Für komplexere Produktionsumgebungen mit höheren Anforderungen an Skalierbarkeit, Ausfallsicherheit und Lastverteilung stößt Docker Compose an seine Grenzen. In solchen Fällen sind fortgeschrittenere Orchestrierungslösungen wie Kubernetes oder Docker Swarm vorzuziehen.
1.2.3. Kommunikation zwischen Docker-Containern
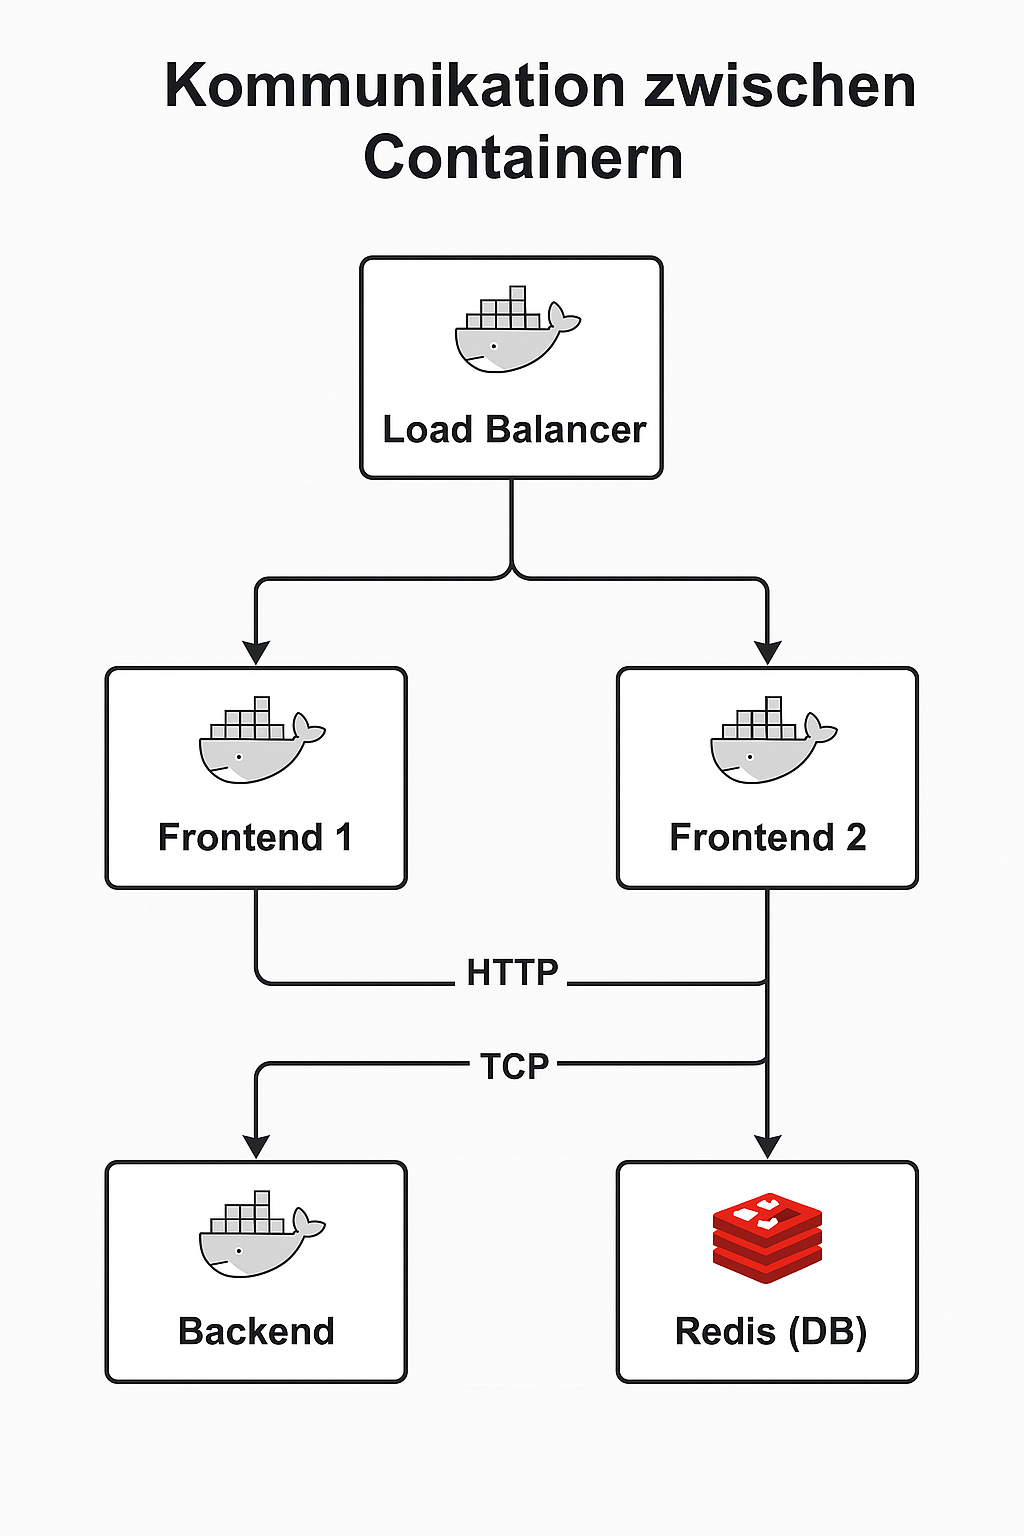
Eine der zentralen Herausforderungen in einer containerisierten Microservice-Architektur ist die zuverlässige, effiziente und sichere Kommunikation zwischen den einzelnen Containern. Da Container in isolierten Umgebungen laufen, müssen sie über definierte Schnittstellen und Netzwerkverbindungen miteinander kommunizieren können. In unserem Projekt – bestehend aus Load Balancer, Frontends, Backend und Redis – spielt die Kommunikation eine zentrale Rolle für den Datenaustausch und die Funktionsfähigkeit des Gesamtsystems.
Docker nutzt standardmäßig ein sogenanntes Bridge-Netzwerk, wenn mehrere Container über docker-compose gestartet werden.
Innerhalb dieses virtuellen Netzwerks können sich Container gegenseitig über ihre Service-Namen ansprechen – ähnlich wie Hostnamen in einem DNS-System.
Dies ermöglicht eine einfache und dynamische Adressierung der Dienste, ohne IP-Adressen manuell konfigurieren zu müssen.
Beispielhafte Kommunikation in unserem Projekt:
- Die Frontend-Container (Streamlit) senden HTTP-Anfragen an die API unter http://backend:5000
- Das Backend (Flask) kommuniziert mit Redis über redis:6379 mittels TCP-Protokoll
- Der Load Balancer (nginx) verteilt HTTP-Anfragen auf die beiden Frontends frontend1 und frontend2
Docker Compose sorgt dabei automatisch für die Einrichtung eines gemeinsam genutzten Netzwerks, sofern in der docker-compose.
yml nichts anderes konfiguriert wird.
Die Konnektivität ist direkt nach dem Start gegeben – es ist keine manuelle Netzwerkdefinition notwendig.
Im YAML-File sieht das folgendermaßen aus:
services:
  backend:
    build: ./backend
    depends_on:
      - redis

  redis:
    image: redis:alpine

networks:
  default:
Durch das gemeinsam genutzte default-Netzwerk können sich alle Services gegenseitig erreichen, ohne zusätzliche Ports freigeben zu müssen (außer bei externem Zugriff).
Ein weiterer Vorteil: **Service-Isolation nach außen.
** Nur Dienste, die explizit mit ports: veröffentlicht werden, sind von außerhalb des Docker-Hosts erreichbar.
In unserem Setup trifft das beispielsweise auf loadbalancer:80 oder backend:5000 zu.
Redis hingegen ist rein intern verfügbar und damit vor Zugriffen von außen geschützt.
Zusätzlich zur Namensauflösung und Isolation bietet Docker weitere Möglichkeiten zur Feinsteuerung der Kommunikation, z.B.:
Benutzerdefinierte Netzwerke: Ermöglichen granulare Kontrolle über Sichtbarkeit und Erreichbarkeit von Containern
Multiple Netzwerke pro Container: Ein Container kann in mehreren Netzwerken aktiv sein – z. B. zur Trennung von Frontend- und Backend-Traffic
Healthchecks und Restart-Strategien: Sichern die dauerhafte Verfügbarkeit einzelner Services und verhindern Kommunikation mit fehlerhaften Instanzen
Im praktischen Projektverlauf zeigte sich, dass die Kommunikation zwischen den Containern äußerst zuverlässig verlief – vorausgesetzt, die depends_on-Reihenfolge war korrekt definiert und alle Services waren bereit.
Für besonders kritische Anwendungsfälle kann zusätzlich ein Service-Wait-Skript eingesetzt werden, das auf den erfolgreichen Start abhängiger Dienste wartet (z. B. Redis-Response),
bevor die Anwendung fortfährt.
Insgesamt stellt die interne Container-Kommunikation einen der größten Vorteile von Docker Compose dar: Dienste lassen sich modular entwickeln, testen und deployen – und kommunizieren dennoch nahtlos über ein gemeinsames virtuelles Netzwerk.
1.2.3.1. Best Practices: Netzwerke statt globaler Portfreigaben
Bei der Konzeption containerbasierter Systeme sollte die Kommunikation zwischen Containern ausschließlich über Docker-interne Netzwerke erfolgen – und nicht über global freigegebene Ports. Docker stellt hierfür automatische Netzwerkfunktionen bereit, die es ermöglichen, dass Container untereinander über ihre Servicenamen kommunizieren können, ohne dass Ports explizit an den Host gebunden werden müssen.
Globale Portfreigaben über ports: in der docker-compose. yml – z. B. 5000:5000 – machen einen Container-Dienst von außen über den Host erreichbar. Dies ist zwar für die Entwicklung oder für externe Schnittstellen notwendig (etwa um die Webanwendung im Browser aufzurufen), sollte aber nicht für interne Container-Kommunikation verwendet werden. Die Gründe:
Sicherheitsrisiko: Jeder geöffnete Port stellt eine potenzielle Angriffsfläche dar.
Firewall-Bypass: Docker konfiguriert eigene iptables-Regeln, die in vielen Fällen vorhandene Firewallregeln umgehen oder aushebeln – ein bewusst geöffneter Port ist also direkt zugänglich, auch wenn die Systemfirewall dies eigentlich verbieten würde.
Netzwerkisolierung wird unterlaufen: Der Sinn einer serviceorientierten Microservice-Architektur mit isolierten Containern wird untergraben, wenn Dienste öffentlich zugänglich sind, obwohl sie ausschließlich intern benötigt werden.
Best Practice ist daher: Nur externe Schnittstellen (z. B. Frontend oder API-Gateway) über Ports exposen, alle anderen Dienste (z. B. Redis, interne APIs) hingegen ausschließlich im internen Docker-Netzwerk kommunizieren lassen. Dies erhöht nicht nur die Sicherheit, sondern reduziert auch den Konfigurationsaufwand und minimiert unbeabsichtigte Seiteneffekte beim Routing und Load Balancing.
1.2.4. Web-Stack in Containern
1.2.4.1. Was ist Streamlit?
Streamlit ist ein modernes Open-Source-Framework, mit dem sich interaktive Webanwendungen direkt in Python erstellen lassen – ohne zusätzliches Wissen in HTML, CSS oder JavaScript. Es wurde speziell für Datenwissenschaftler:innen und Entwickler:innen entwickelt, die schnell visuelle Oberflächen oder Dashboards benötigen, ohne sich mit klassischen Webtechnologien auseinandersetzen zu müssen.
Im Gegensatz zu traditionellen Web-Frameworks wie Flask oder Django arbeitet Streamlit deklarativ. Das bedeutet: Der Code beschreibt den Zustand der Benutzeroberfläche und wird bei jeder Benutzerinteraktion vollständig neu ausgewertet. So bleibt die Logik sehr einfach und vorhersehbar.
1.2.4.2. Warum Streamlit in unserem Projekt?
In unserem Docker-Projekt nutzen wir Streamlit als Frontend, also als Benutzeroberfläche. Die Gründe dafür sind:
Schnelle Entwicklung: Eine funktionale UI ist in wenigen Minuten umsetzbar.
Volle Python-Integration: Alle Datenverarbeitungsschritte, API-Requests oder Visualisierungen passieren in Python.
Keine Webdesign-Kenntnisse notwendig: Die Benutzeroberfläche sieht ansprechend aus – ganz ohne HTML oder CSS.
Einfach zu bedienen: Ideal für Projekte mit Fokus auf Funktion statt Design.
Gut integrierbar in Containerstrukturen: Streamlit lässt sich einfach per
Dockerfilein ein Service-Setup einbinden.
1.2.4.3. So funktioniert Streamlit
Ein typisches Streamlit-Skript besteht aus einem linearen Python-Code, der beim Aufruf der Web-App von oben nach unten ausgeführt wird. Es verwendet sogenannte Widgets, also Eingabeelemente (Textfelder, Buttons, Slider etc.), die den Zustand der App beeinflussen.
Alle Änderungen an diesen Eingabeelementen führen dazu, dass der gesamte Code erneut ausgeführt wird – ähnlich wie in einem Jupyter Notebook mit interaktiven Zellen.
1.2.4.4. Beispiel 1: Benutzerverwaltung
Das folgende Beispiel zeigt, wie man in Streamlit eine einfache Benutzerverwaltung mit Auswahl, Bearbeitung und Löschung umsetzt.
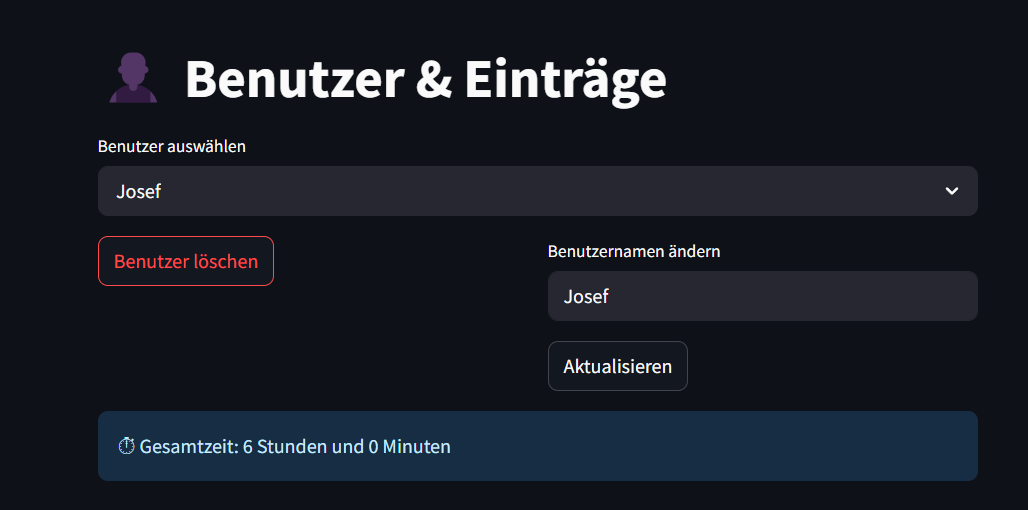
Erklärung der Elemente:
st.selectbox(...)– Dropdown zur Auswahl eines vorhandenen Benutzersst.columns(...)– Spaltenlayout für Buttonsst.text_input(...)– Eingabefeld zum Ändern des Benutzernamensst.button(...)– Auslöser für Löschen und Aktualisieren
Beispielcode:
user_names = {u['name']: u['id'] for u in users}
selected_user_name = st.selectbox("Benutzer auswählen", ["-- Benutzer wählen --"] + list(user_names.keys()))

if selected_user_name != "-- Benutzer wählen --":
    selected_user_id = user_names[selected_user_name]

    col1, col2 = st.columns([1, 1])
    with col1:
        if st.button("Benutzer löschen"):
            requests.delete(f"{API_URL}/users/{selected_user_id}")
            st.rerun()
    with col2:
        new_name = st.text_input("Benutzernamen ändern", value=selected_user_name)
        if st.button("Aktualisieren") and new_name.strip():
            requests.put(f"{API_URL}/users/{selected_user_id}", json={"name": new_name.strip()})
            st.rerun()
1.2.4.5. Was ist Flask?
Flask ist ein leichtgewichtiges, modular aufgebautes Web-Framework für Python, das es ermöglicht, schnell und einfach HTTP-basierte Schnittstellen (APIs) zu entwickeln. Es basiert auf dem WSGI-Standard und eignet sich hervorragend für Microservice-Architekturen, da es bewusst minimalistisch gehalten ist – du verwendest nur die Komponenten, die du wirklich brauchst.
Im Vergleich zu größeren Frameworks wie Django verzichtet Flask auf ein festes Projektgerüst und lässt dir mehr Freiheit bei der Strukturierung deines Codes. Dies macht es besonders geeignet für schlanke Backend-Dienste in containerisierten Anwendungen.
1.2.4.6. Warum Flask in unserem Projekt?
In unserer Container-Architektur übernimmt Flask die Rolle des Backends. Es nimmt HTTP-Anfragen entgegen (z. B. von einem Frontend wie Streamlit), verarbeitet Daten, kommuniziert mit Redis oder anderen Services und sendet eine Antwort zurück.
Vorteile im Projektkontext:
Einfaches Routing: HTTP-Endpunkte sind schnell definiert.
Klein und performant: Keine unnötige Overhead.
Gute Erweiterbarkeit: Z. B. für Validierung, Logging oder Authentifizierung.
Perfekt für REST-APIs geeignet.
Leicht dockerisierbar.
1.2.4.7. Beispiel: Eine einfache Flask-API
Nachfolgend ein Beispiel für eine einfache Flask-Anwendung, die Benutzer sowie zugehörige Einträge verwaltet. In einer späteren Version werden die Daten in Redis gespeichert.
from flask import Flask, request, jsonify
import uuid

app = Flask(__name__)

# In-Memory-Speicher (wird später durch Redis ersetzt)
users = {}
entries = {}

@app.route('/users', methods=['POST'])
def create_user():
    data = request.json
    user_id = str(uuid.uuid4())
    data['id'] = user_id
    users[user_id] = data
    entries[user_id] = []
    return jsonify(data), 201

@app.route('/users', methods=['GET'])
def get_users():
    return jsonify(list(users.values()))

@app.route('/users/<user_id>/entries', methods=['POST'])
def add_entry(user_id):
    data = request.json
    data['id'] = str(uuid.uuid4())
    entries[user_id].append(data)
    return jsonify(data), 201

@app.route('/users/<user_id>/entries', methods=['GET'])
def get_entries(user_id):
    return jsonify(entries.get(user_id, []))

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
1.2.4.8. Erklärung wichtiger Zeilen
Zeile |
Funktion |
|---|---|
|
Temporärer Speicher für Benutzer und Einträge |
|
Erzeugt eindeutige IDs für User und Einträge |
|
Fügt einen neuen Benutzer hinzu |
|
Gibt alle Benutzer zurück |
|
Fügt Einträge hinzu bzw. listet sie für einen Benutzer |
1.2.4.9. API-Design im Projekt
Die API bildet die Schnittstelle zwischen dem Frontend (Streamlit) und der Datenhaltung (später Redis). Die aktuelle Logik:
POST /userslegt einen neuen Benutzer mit eindeutiger ID anGET /usersgibt alle angelegten Benutzer zurückPOST /users/<user_id>/entriesfügt einen Eintrag (Thema, Datum, Zeit) zum Benutzer hinzuGET /users/<user_id>/entriesgibt alle Einträge eines Benutzers zurück
Damit ist die API benutzerorientiert aufgebaut und entspricht den Prinzipien einer klar strukturierten REST-Schnittstelle, wie sie in modularen Systemen üblich ist.
1.2.4.10. Ausblick: Anbindung an Redis
Der nächste Schritt ist die Integration eines Key-Value-Stores (Redis). Dabei werden:
- Benutzerbezogene Einträge unter Schlüsseln wie user_entries:<user_id> abgelegt
1.2.5. Datenhaltung mit Redis (Key-Value-Store)
1.2.5.1. Was ist Redis?
Redis (REmote DIctionary Server) ist ein In-Memory Key-Value-Store, der sich hervorragend für performante Datenhaltung eignet. Redis speichert Daten standardmäßig im Arbeitsspeicher, wodurch extrem schnelle Lese- und Schreibzugriffe möglich sind. Zusätzlich kann Redis die Daten auf die Festplatte schreiben, um Persistenz zu ermöglichen.
Typische Anwendungsfälle:
Caching
Sitzungsverwaltung
Nachrichtenwarteschlangen
Temporäre Datenhaltung
Zentrale Datenablage in Microservice-Architekturen
1.2.5.2. Warum Redis in unserem Projekt?
In unserem containerisierten Web-Stack nutzen wir Redis als zentrale Datenhaltungsschicht für die Aufgaben, die vom Frontend erfasst und vom Backend verarbeitet werden. Die Gründe dafür:
Einfaches Datenmodell: Key-Value-Prinzip passt gut zu unserem Zweck (z. B. Benutzername → Liste von Aufgaben).
Schnelle Zugriffszeiten: Ideal für wiederholte Lese- und Schreibvorgänge.
Leichtgewichtig: Sehr ressourcenschonend, ideal für Container.
Mehrere Clients gleichzeitig: Sowohl Flask (Backend) als auch Tools wie redis-cli oder Streamlit können auf Redis zugreifen.
1.2.5.3. Integration in flask
In der Praxis wird Redis als externer Dienst vom Flask-Backend aus angesprochen. Dies erfolgt über eine Redis-Client-Bibliothek, z. B. redis-py.
1.2.5.4. Beispiel: Benutzer und Einträge in Redis speichern
import redis
import json
import uuid
from flask import Flask, request, jsonify

app = Flask(__name__)

# Verbindung zu Redis (Docker-Container-Name = "redis")
r = redis.Redis(host='redis', port=6379, decode_responses=True)

USERS_KEY = "users"

def get_entries_key(user_id):
    return f"user_entries:{user_id}"

@app.route('/users', methods=['POST'])
def create_user():
    users = json.loads(r.get(USERS_KEY)) if r.get(USERS_KEY) else []
    data = request.json
    data['id'] = str(uuid.uuid4())
    users.append(data)
    r.set(USERS_KEY, json.dumps(users))
    return jsonify(data), 201

@app.route('/users', methods=['GET'])
def get_users():
    users = json.loads(r.get(USERS_KEY)) if r.get(USERS_KEY) else []
    return jsonify(users)

@app.route('/users/<user_id>/entries', methods=['POST'])
def add_entry(user_id):
    key = get_entries_key(user_id)
    entries = json.loads(r.get(key)) if r.get(key) else []
    data = request.json
    data['id'] = str(uuid.uuid4())
    entries.append(data)
    r.set(key, json.dumps(entries))
    return jsonify(data), 201

@app.route('/users/<user_id>/entries', methods=['GET'])
def get_entries(user_id):
    key = get_entries_key(user_id)
    entries = json.loads(r.get(key)) if r.get(key) else []
    return jsonify(entries)

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
1.2.5.5. Erklärung der Redis-Funktionen
Funktion |
Beschreibung |
|---|---|
|
Verbindet mit Redis im Container-Netzwerk |
|
Speichert alle Benutzer in einem JSON-Array unter dem Key |
|
Holt gespeicherte Daten aus Redis |
|
Individueller Key zur Speicherung der Einträge eines Benutzers |
|
Speichert Einträge als JSON-Liste unter dem User-Key |
1.2.5.6. Visualisierung der Redis-Datenstruktur
Redis (Key-Value Store)
├── "users": [
│      {"id": "uuid-1", "name": "Anna"},
│      {"id": "uuid-2", "name": "Max"}
│   ]
├── "user_entries:uuid-1": [
│      {"id": "uuid-a", "datum": "2025-04-05", "thema": "Docker", "stunden": 2, "minuten": 30},
│      {"id": "uuid-b", "datum": "2025-04-06", "thema": "Streamlit", "stunden": 1, "minuten": 0}
│   ]
├── "user_entries:uuid-2": [
│      {"id": "uuid-c", "datum": "2025-04-03", "thema": "API", "stunden": 1, "minuten": 45}
│   ]
1.2.5.7. Datenaustausch im Projekt
Komponente |
Aufgabe |
|---|---|
Streamlit |
Auswahl, Anzeige und Eingabe durch Benutzer (UI) |
Flask |
Schnittstelle (API) zur Datenverarbeitung |
Redis |
Persistente Speicherung von Benutzern und deren Einträgen |
Streamlit |
Visualisierung aller gespeicherten Daten nach Benutzerfilterung |
—
1.2.5.8. Loadbalancing mit NGINX
Zur besseren Lastverteilung und Skalierbarkeit verwenden wir in unserem Projekt einen NGINX-Container als Loadbalancer. Dieser verteilt eingehende HTTP-Anfragen gleichmäßig auf zwei Frontend-Container (frontend1, frontend2), die identische Streamlit-Anwendungen ausführen.
NGINX greift dazu auf die Funktionalität von Upstreams zurück. Die Konfiguration basiert auf dem Prinzip least_conn, bei dem die Verbindung immer zum Frontend mit den aktuell wenigsten offenen Sessions erfolgt.
Dies hat folgende Vorteile:
Mehrere Benutzer können gleichzeitig arbeiten, ohne dass ein einzelner Container überlastet wird
Die Anwendung bleibt auch bei steigendem Datenvolumen reaktionsschnell
Container können unabhängig voneinander neu gestartet oder ersetzt werden
Beispielkonfiguration (Auszug):
upstream frontends {
    least_conn;
    server frontend1:80;
    server frontend2:80;
}

server {
    listen 80;

    location / {
        proxy_pass http://frontends;
        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
    }
}
1.2.5.9. Ablauf einer Benutzeraktion (z.B. Eintrag hinzufügen)
Zugriff über Loadbalancer Der Benutzer öffnet die Anwendung über localhost:80. NGINX leitet die Anfrage automatisch an frontend1 oder frontend2 weiter.
Eingabe im Frontend (Streamlit) Die Streamlit-Oberfläche ermöglicht dem Benutzer die Auswahl eines bestehenden Benutzers oder das Anlegen eines neuen. Anschließend kann ein Eintrag mit Datum, Thema, Stunden und Minuten hinzugefügt werden.
Verarbeitung im Backend (Flask) Das Frontend sendet die Daten an die API-Endpunkte (/users, /users/<id>/entries). Flask verarbeitet die Anfrage, ergänzt eindeutige IDs und leitet die Daten zur Speicherung weiter.
Speicherung in Redis - Zu jedem Benutzer werden Einträge unter dem Key
user_entries:<user_id>geführtAktualisierung der Benutzeroberfläche Nach erfolgreicher Speicherung werden alle Einträge erneut abgerufen und dem Benutzer angezeigt. Die Gesamtzeit aller Einträge wird aus Stunden und Minuten berechnet und als Zusammenfassung dargestellt.
1.2.5.10. Technischer Ablauf (vereinfacht)
[Browser des Nutzers]
       │
       ▼
[NGINX Loadbalancer]
       │
       ▼
[Streamlit Frontend 1/2]
       │     POST /users/<id>/entries
       ▼
    [Flask API]
       │
       ▼
    [Redis Datenbank]
Visualisierung der Redis-Schlüsselstruktur:
"users" → [
    {"id": "...", "name": "Anna"},
    {"id": "...", "name": "Ben"}
]

"user_entries:<user_id>" → [
    {"datum": "...", "thema": "...", "stunden": 2, "minuten": 30},
    ...
]
1.2.6. Datenpersistenz mit Docker Volumes
Datenverlust bei Neustart: Ohne persistente Speicherung gehen alle Daten verloren, wenn ein Container neu gestartet wird.
Erschwerte Updates: Software-Updates erfordern oft einen Neustart oder Neuerstellung des Containers.
Ineffiziente Skalierung: Bei horizontaler Skalierung müssen Daten zwischen Container-Instanzen geteilt werden.
Docker bietet mehrere Lösungen für diese Herausforderungen, wobei Docker Volumes die empfohlene Methode darstellen.
1.2.6.1. Docker Volumes: Grundlagen und Vorteile
Docker Volumes sind ein Mechanismus zum Speichern von Daten außerhalb des Container-Dateisystems. Sie bieten folgende Vorteile:
Persistenz: Daten bleiben auch nach Löschung des Containers erhalten
Bessere Performance: Volumes umgehen die Copy-on-Write-Strategie des Containers
Einfache Sicherung: Volumes können einfach gesichert und wiederhergestellt werden
Portabilität: Volumes können zwischen verschiedenen Containern geteilt werden
In unserem Projekt nutzen wir Docker Volumes für zwei wichtige Datenspeicherungen:
Redis-Datenbank für die Task-Verwaltung
1.2.6.2. Redis-Persistenz mit RDB und Volume-Mount
Redis ist eine In-Memory-Datenbank, die standardmäßig ihre Daten nur im Arbeitsspeicher hält. Für Persistenz bietet Redis zwei Hauptmechanismen:
RDB (Redis Database): Punktuelle Snapshots der Datenbank
AOF (Append Only File): Protokollierung aller Schreiboperationen
In unserem Docker-Compose-Setup verwenden wir RDB in Kombination mit einem Docker Volume:
services:
  redis:
    image: redis:alpine
    container_name: redis
    ports:
      - "6379:6379"
    volumes:
      - redis_data:/data

volumes:
  redis_data:
Redis speichert in der standardmäßigen Konfiguration seine RDB-Dateien im Verzeichnis /data. Durch das Mounten des Volumes redis_data an diesen Pfad werden die RDB-Snapshots außerhalb des Containers gespeichert und bleiben erhalten, auch wenn der Container neu erstellt wird.
Redis-Persistenz im Detail:
Redis schreibt in regelmäßigen Abständen einen Snapshot (dump.rdb) in das Verzeichnis
/dataDiese Snapshots enthalten den kompletten Zustand der Datenbank
Bei einem Neustart lädt Redis automatisch den letzten Snapshot
Dadurch bleiben alle TODO-Listen-Einträge erhalten
1.2.6.3. Sicherheitsaspekte und Best Practices
Bei der Arbeit mit Docker Volumes und persistenten Daten sollten folgende Sicherheitsaspekte beachtet werden:
Zugriffsrechte: Volumes sollten mit angemessenen Berechtigungen konfiguriert werden
Backup-Strategie: Regelmäßige Sicherungen der Volume-Daten
Verschlüsselung: Sensitive Daten sollten verschlüsselt werden
Isolation: Jede Anwendung sollte eigene Volumes verwenden
In unserem Projekt setzen wir diese Best Practices wie folgt um:
Klare Trennung zwischen flüchtigen und persistenten Daten
Minimale Zugriffsrechte für die Container
1.3. Versuchsdurchführung
Die Grundlage unseres Projekts bildet Docker. Docker ist eine Plattform zur Containervirtualisierung, die es ermöglicht, Anwendungen in isolierten Umgebungen auszuführen.
Installationsanleitung:
# Für Ubuntu/Debian-basierte Systeme
sudo apt-get update
sudo apt-get install docker.io docker-compose

# Für Windows/macOS
# Docker Desktop von https://www.docker.com/products/docker-desktop herunterladen und installieren
Nach der Installation sollte geprüft werden, ob Docker korrekt funktioniert:
docker --version
docker-compose --version
1.3.1. Projektstart und Zugriff
Das gesamte Projekt kann mit einem einzigen Befehl gestartet werden:
docker-compose up --build
Mit der Option -d kann die Anwendung im Hintergrund gestartet werden:
docker-compose up -d --build
- Nach dem Start der Container ist die Anwendung unter folgenden URLs erreichbar:
Todo-Anwendung: http://localhost:80
Benutzer-Frontend: http://localhost:80/users
Backend-API: http://localhost:5000
Zur Überprüfung der Funktionsweise und Zuverlässigkeit unseres containerisierten Systems wurden zwei gezielte Versuche durchgeführt. Diese Tests zeigen das Zusammenspiel der Komponenten unter realistischen Bedingungen und verdeutlichen zentrale Aspekte wie Load Balancing und Datenpersistenz.
1.3.2. Versuche
1.3.2.1. Versuch 1: Lastverteilung durch den Load Balancer
Ziel dieses Versuchs war es, das Verhalten des Load Balancers bei wiederholten Benutzeranfragen zu untersuchen.
Dazu wurde die TODO-Anwendung mehrfach im Browser aufgerufen (http://localhost:80), wobei der Browser jeweils neu geladen (Refresh) wurde.
Beobachtung:
- Bei jedem Reload wurde der Benutzer zu einer der beiden Frontend-Instanzen weitergeleitet – frontend1 oder frontend2
- Dies zeigte sich visuell durch kleine Unterschiede in der Darstellung (z. B. leicht verändertes Logging im Frontend)
- Der Load Balancer (nginx) verteilte die Anfragen im Round-Robin-Verfahren
Ergebnis: - Die Lastverteilung funktionierte wie erwartet - Beide Frontends wurden gleichmäßig genutzt - Der Benutzer merkt davon im Normalbetrieb nichts – die Anwendung bleibt funktional und reaktionsschnell
Diese Beobachtung bestätigt die erfolgreiche Integration von horizontal skalierbaren Frontend-Komponenten hinter einem Load Balancer.
1.3.2.2. Versuch 2: Container-Neustart und Prüfung der Datenpersistenz
Im zweiten Versuch wurde der Redis-Datenbankcontainer gezielt neugestartet, um die Persistenz der gespeicherten Aufgaben zu überprüfen. Vorgehen:
Über die Streamlit-Oberfläche wurde eine neue Aufgabe hinzugefügt.
Die erfolgreiche Speicherung wurde durch die Rückmeldung der API bestätigt.
Anschließend wurde der Redis-Container gestoppt und neu gestartet:
docker-compose restart redis
Nach dem Neustart wurde die Anwendung erneut aufgerufen und die gespeicherten Aufgaben abgerufen.
Ergebnis:
- Die zuvor gespeicherten Aufgaben waren vollständig erhalten
- Die Persistenzfunktion durch das gemountete Docker Volume funktionierte korrekt
- Redis hatte beim Neustart automatisch den letzten Snapshot geladen (dump.rdb)
Diese erfolgreiche Wiederherstellung der Daten zeigt, dass unser System ausfallsicher und stabil gegenüber Container-Neustarts ist – ein zentrales Ziel von containerisierten Produktionsumgebungen.
Zusammenfassung: - Load Balancing funktioniert zuverlässig und sorgt für gleichmäßige Auslastung der Frontends - Datenpersistenz über Volumes gewährleistet, dass Benutzerdaten nicht verloren gehen, selbst bei unerwarteten Neustarts oder Updates einzelner Dienste
Diese Tests belegen die Praxistauglichkeit der gewählten Architektur.
1.4. Fazit
Das Projekt veranschaulicht überzeugend, wie durch den Einsatz von Docker in Kombination mit dem Microservice-Prinzip eine moderne, modulare und skalierbare Webanwendung realisiert werden kann. Die strukturierte Aufteilung in Frontend, Backend und Datenhaltung schafft klare Verantwortlichkeiten und erleichtert sowohl die Entwicklung als auch die Wartung der Anwendung.
Durch den Einsatz von Docker Compose wird eine effiziente Orchestrierung der einzelnen Komponenten ermöglicht, was ein konsistentes und reproduzierbares Setup sicherstellt. Zentrale Konzepte wie Container-Isolierung, Netzwerkkommunikation, Datenpersistenz und Load Balancing wurden praxisnah umgesetzt und erfolgreich validiert.
Die gewählte Architektur eignet sich nicht nur für Entwicklungszwecke, sondern bietet auch eine tragfähige Grundlage für produktionsnahe Szenarien. Insgesamt bestätigt das Projekt, dass Docker ein leistungsstarkes Werkzeug für die Umsetzung zeitgemäßer Softwarearchitekturen darstellt.
1.5. Literatur und Quellen
Flask (Backend-Framework) https://flask.palletsprojects.com/en/stable/
Streamlit (Frontend-Framework) https://streamlit.io/
Redis (Key-Value Store) https://redis.io/docs/latest/
Docker Grundlagen https://docs.docker.com/get-started/docker-overview/
Docker Compose Docs https://docs.docker.com/compose/
RDB in redis https://medium.com/redis-with-raphael-de-lio/understanding-persistence-in-redis-aof-rdb-on-docker-dcc176ea439