5. Experiment 5: [Local AI]
Datum: [06.06.2024] Thema: [Local AI (Lama etc.)]
5.1. Einleitung
In der heutigen Zeit ist es üblich das jeder mit AI (Artificial Intelligence / Künstliche Intelligenz) in Kontakt kommt. Sei es durch die Nutzung von ChatBots wie ChatGPT und Gemini. Diese haben den Vorteil, das die Benutzung sehr einfach ist, jedoch könnten Daten an Dritte weitergegeben werden, allein schön für die Verarbeitung. Um die Kontrolle über seine Daten zu behalten ist es sinnvoll, eine eigenes AI Modell auf dem eigenen Rechner, oder auf einem eigenen Server zu betreiben.
5.1.1. Motivation
Die Motivation für dieses Experiment ist es, eine bereits vorhandene AI, auf dem eigenen Rechner laufen zu lassen. Um hierbei eine möglichst einfache Einbindung auf weiteren Systemen zu ermöglichen, schauen wir uns mehere Möglichkeiten an, die uns zur Verfügung stehen.
5.1.2. Aufgabenstellung
Es soll eine AI auf dem eigenen Rechner laufen, die in der Lage ist, auf Anfragen zu antworten. Es wird zudem untersucht, welche Möglichkeiten es gibt, möglichst einfach eine AI auf einem System zu betreiben.
5.2. Grundlagen
Um ein grundsätzliches Verständnis für das Thema zu schaffen, werden im Folgenden einige grundlegende Begriffe erläutert.
5.2.1. Was ist eine AI / KI?
Künstliche Intelligenz (KI) oder auch Artificial Intelligence (AI) ist ein Teilgebiet der Informatik, das sich mit der Entwicklung von Algorithmen und Computersystemen befasst, die menschenähnliche Intelligenz aufweisen. KI-Systeme können lernen, Schlussfolgerungen ziehen, Probleme lösen und menschenähnliche Aufgaben ausführen. KI-Technologien umfassen maschinelles Lernen, neuronale Netze, Computer Vision, natürliche Sprachverarbeitung und Robotik.
5.2.2. Was sind ChatBots?
ChatBots sind KI-Systeme, die in der Lage sind, menschenähnliche Konversationen zu führen. Sie können auf Anfragen antworten, Informationen bereitstellen, Aufgaben ausführen und Benutzer unterstützen. ChatBots werden in verschiedenen Branchen eingesetzt, darunter Kundenservice, E-Commerce, Bildung und Gesundheitswesen.
5.2.3. Was sind LLMs?
Large Language Models basieren auf den Prinzipien des Deep Learning und nutzen neuronale Netzwerkarchitekturen, um menschliche Sprachen zu verarbeiten und zu verstehen.
Diese Modelle werden mithilfe selbstüberwachter Lerntechniken anhand umfangreicher Datensätze trainiert. Dabei werden die Modelle mit sehr großen Mengen an Textdaten gefüttert, um ein tiefes Verständnis der Sprache zu entwickeln. LLMs bestehen aus mehreren Schichten, einschließlich Feedforward-Schichten, Einbettungsschichten und Aufmerksamkeitsschichten. Sie nutzen Aufmerksamkeitsmechanismen wie Selbstaufmerksamkeit, um die Bedeutung verschiedener Token in einer Sequenz abzuwägen, sodass das Modell Abhängigkeiten und Beziehungen erfassen kann.
5.2.4. Was ist Llama?
Llama ist ein Large Language Model (LLM), das von Meta entwickelt wurde. Es basiert auf der Programmiersprache Python und kann als ChatBot oder als KI-Assistent genutzt werden. Llama ist OpenSource und kann von Entwicklern und Forschern genutzt werden, um KI-Modelle zu trainieren und zu evaluieren.
5.2.5. Warum AI auf dem eigenen Rechner?
Es gibt mehrere Gründe, warum es sinnvoll sein kann, ein AI Modell auf dem eigenen Rechner zu betreiben:
Datenschutz: Durch die Nutzung einer lokalen AI können sensible Daten auf dem eigenen Rechner verarbeitet werden, ohne dass sie an Dritte weitergegeben werden.
Geschwindigkeit: Eine lokale AI kann schneller auf Anfragen reagieren, da sie nicht von einer Internetverbindung abhängig ist.
Anpassbarkeit: Eine lokale AI kann an die individuellen Bedürfnisse und Anforderungen angepasst werden, da sie auf dem eigenen Rechner läuft.
Jedoch gibt es auch einige Hindernisse, die bei der Bereitstellung einer AI auf dem eigenen Rechner Auftreten können:
Ressourcen: Eine AI benötigt viel Rechenleistung und Speicherplatz, um effektiv zu funktionieren.
Komplexität: Die Einrichtung und Konfiguration einer AI auf dem eigenen Rechner kann komplex sein und erfordert Kenntnisse in den Bereichen AI, Programmierung und Systemadministration.
Wartung: Eine lokale AI muss regelmäßig gewartet und aktualisiert werden, um sicherzustellen, dass sie effektiv und sicher funktioniert.
5.3. Versuchsdurchführung
Zunächst benötigen wir ein LLM (Large Language Model) wie z.B. GPT-3 von OpenAI, Llama von Meta oder BERT von Google. In diesem Experiment haben wir uns zunächst für Llama entschieden, da es OpenSource ist und somit von jedem genutzt werden kann. Llama ist ein LLM, das von Meta entwickelt wurde und auf der Programmiersprache Python basiert. Es ist in der Lage, auf Anfragen zu antworten und kann auch als ChatBot genutzt werden, was für unsere Ansprüche ausreichte.
Um Llama auf dem eigenen Rechner zu betreiben, mussten wir folgenden Schritte durchführen:
Zugänglichkeit an Llama Anfordern: Da Llama von Meta entwickelt wurde, mussten wir Zugriff auf die Llama-Plattform anfordern, um die erforderlichen Download-Schlüssel zu erhalten.
- WSL installation: Da das installastionskript eine Makefile für Linux ist, haben wir uns für Windows Subsystem für Linux entschieden . Hierfür haben wir die folgenden befehle ausgeführt:
- wsl –unregister Ubuntu
wsl –unregister Ubuntu sollte dabei sicher stellen, das keine andere Ubuntu Instanz auf dem Rechner läuft.
wsl –install -d Ubuntu
- Python Installation: Nach der Installation von WSL haben wir Python im Subsystem installiert. Hierfür haben wir die folgenden Befehle ausgeführt:
sudo apt update bzw. upgrade
sudo apt install python3-pip
sudo apt install python3-venv
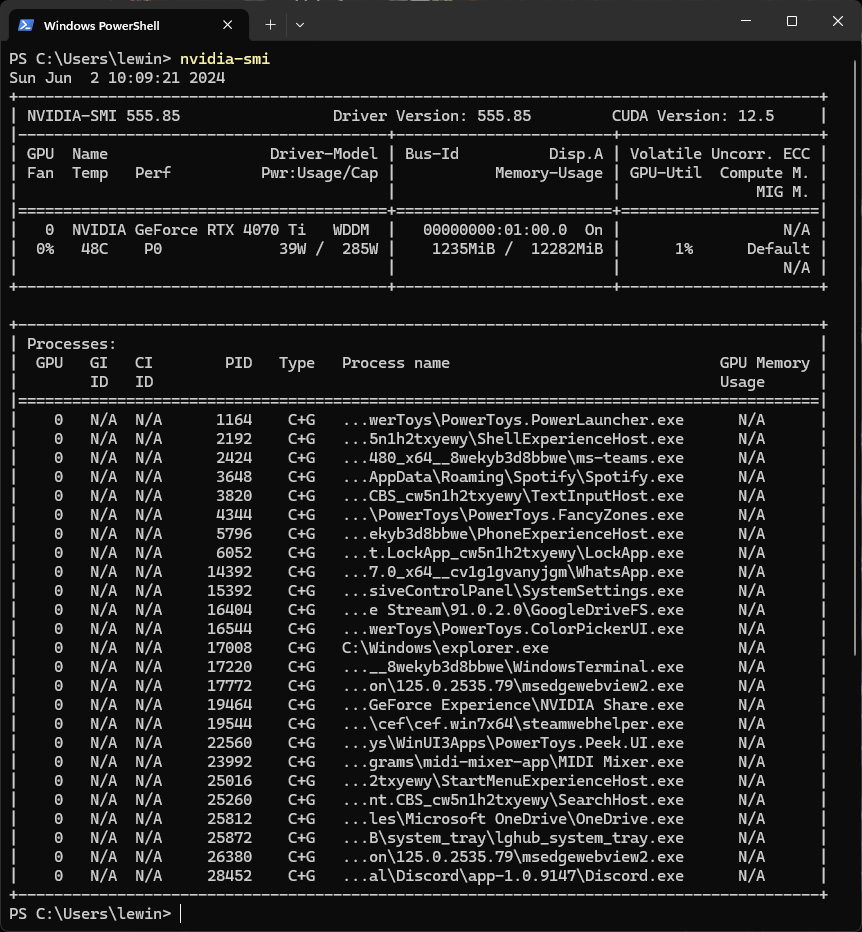
- Überprüfung der CUDA Version in der Windows PowerShell: Da LLMs auf der GPU am schnellsten laufen welche mit CUDA genutzt werden kann, haben wir die Version von CUDA in Windows PowerShell überprüft, um sicherzustellen, dass wir die Richtige PyTorch Version nutzen. Hierfür haben wir den folgenden Befehl ausgeführt:
nvidia-smi
- Installation der richtigen PyTorch Version, die mit unserer CUDA Version kompatibel ist:
https://pytorch.org/get-started/locally/ kann man den richtigen pip Befehl nachsehen:
pip3 install torch torchvision torchaudio
Nachdem die erforderlichen Vorbereitung durchgeführt wurden, konnten wir beginnen Llama zu Clonen und zu installieren. Hierfür haben wir die folgenden Befehle ausgeführt:
- Clonen des Llama Repository:
git clone https://github.com/meta-llama/llama3.git
cd llama
pip3 install -r requirements.txt
Laufen lassen des download.sh Skripts um die gewünschten Modelle zu installieren. Wir haben uns dabei entschieden die kleineres Modell von Llama zu installieren, da diese die größeren Modelle schnell mehr als unsere 32GB Arbeitsspeicher nutzen.
- Nutzen des Modells: Hierfür haben wir den folgenden Befehl ausgeführt:
torchrun –nproc_per_node 1 example_chat_completion.py –ckpt_dir Meta-Llama-3-8B-Instruct/ –tokenizer_path Meta-Llama-3-8B-Instruct/tokenizer.model –max_seq_len 512 –max_batch_size 6
Diese Konfiguration sollte es ermöglichen die AI mit dem testskript „example_chat_completion.py“ auf dem eigenen Rechner zu betreiben. Jedoch haben wir festgestellt, das es bei unseren Rechnern zu Problemen führt. Diesen haben wir auch nach vielem rumprobieren nicht wirklich gelöst bekommen. Daher haben wir uns entschieden, einen anderen Ansatz zu wählen. Bei den Recherchen sind wir auf ein OpenSource Projekt gestoßen namens JanAI.
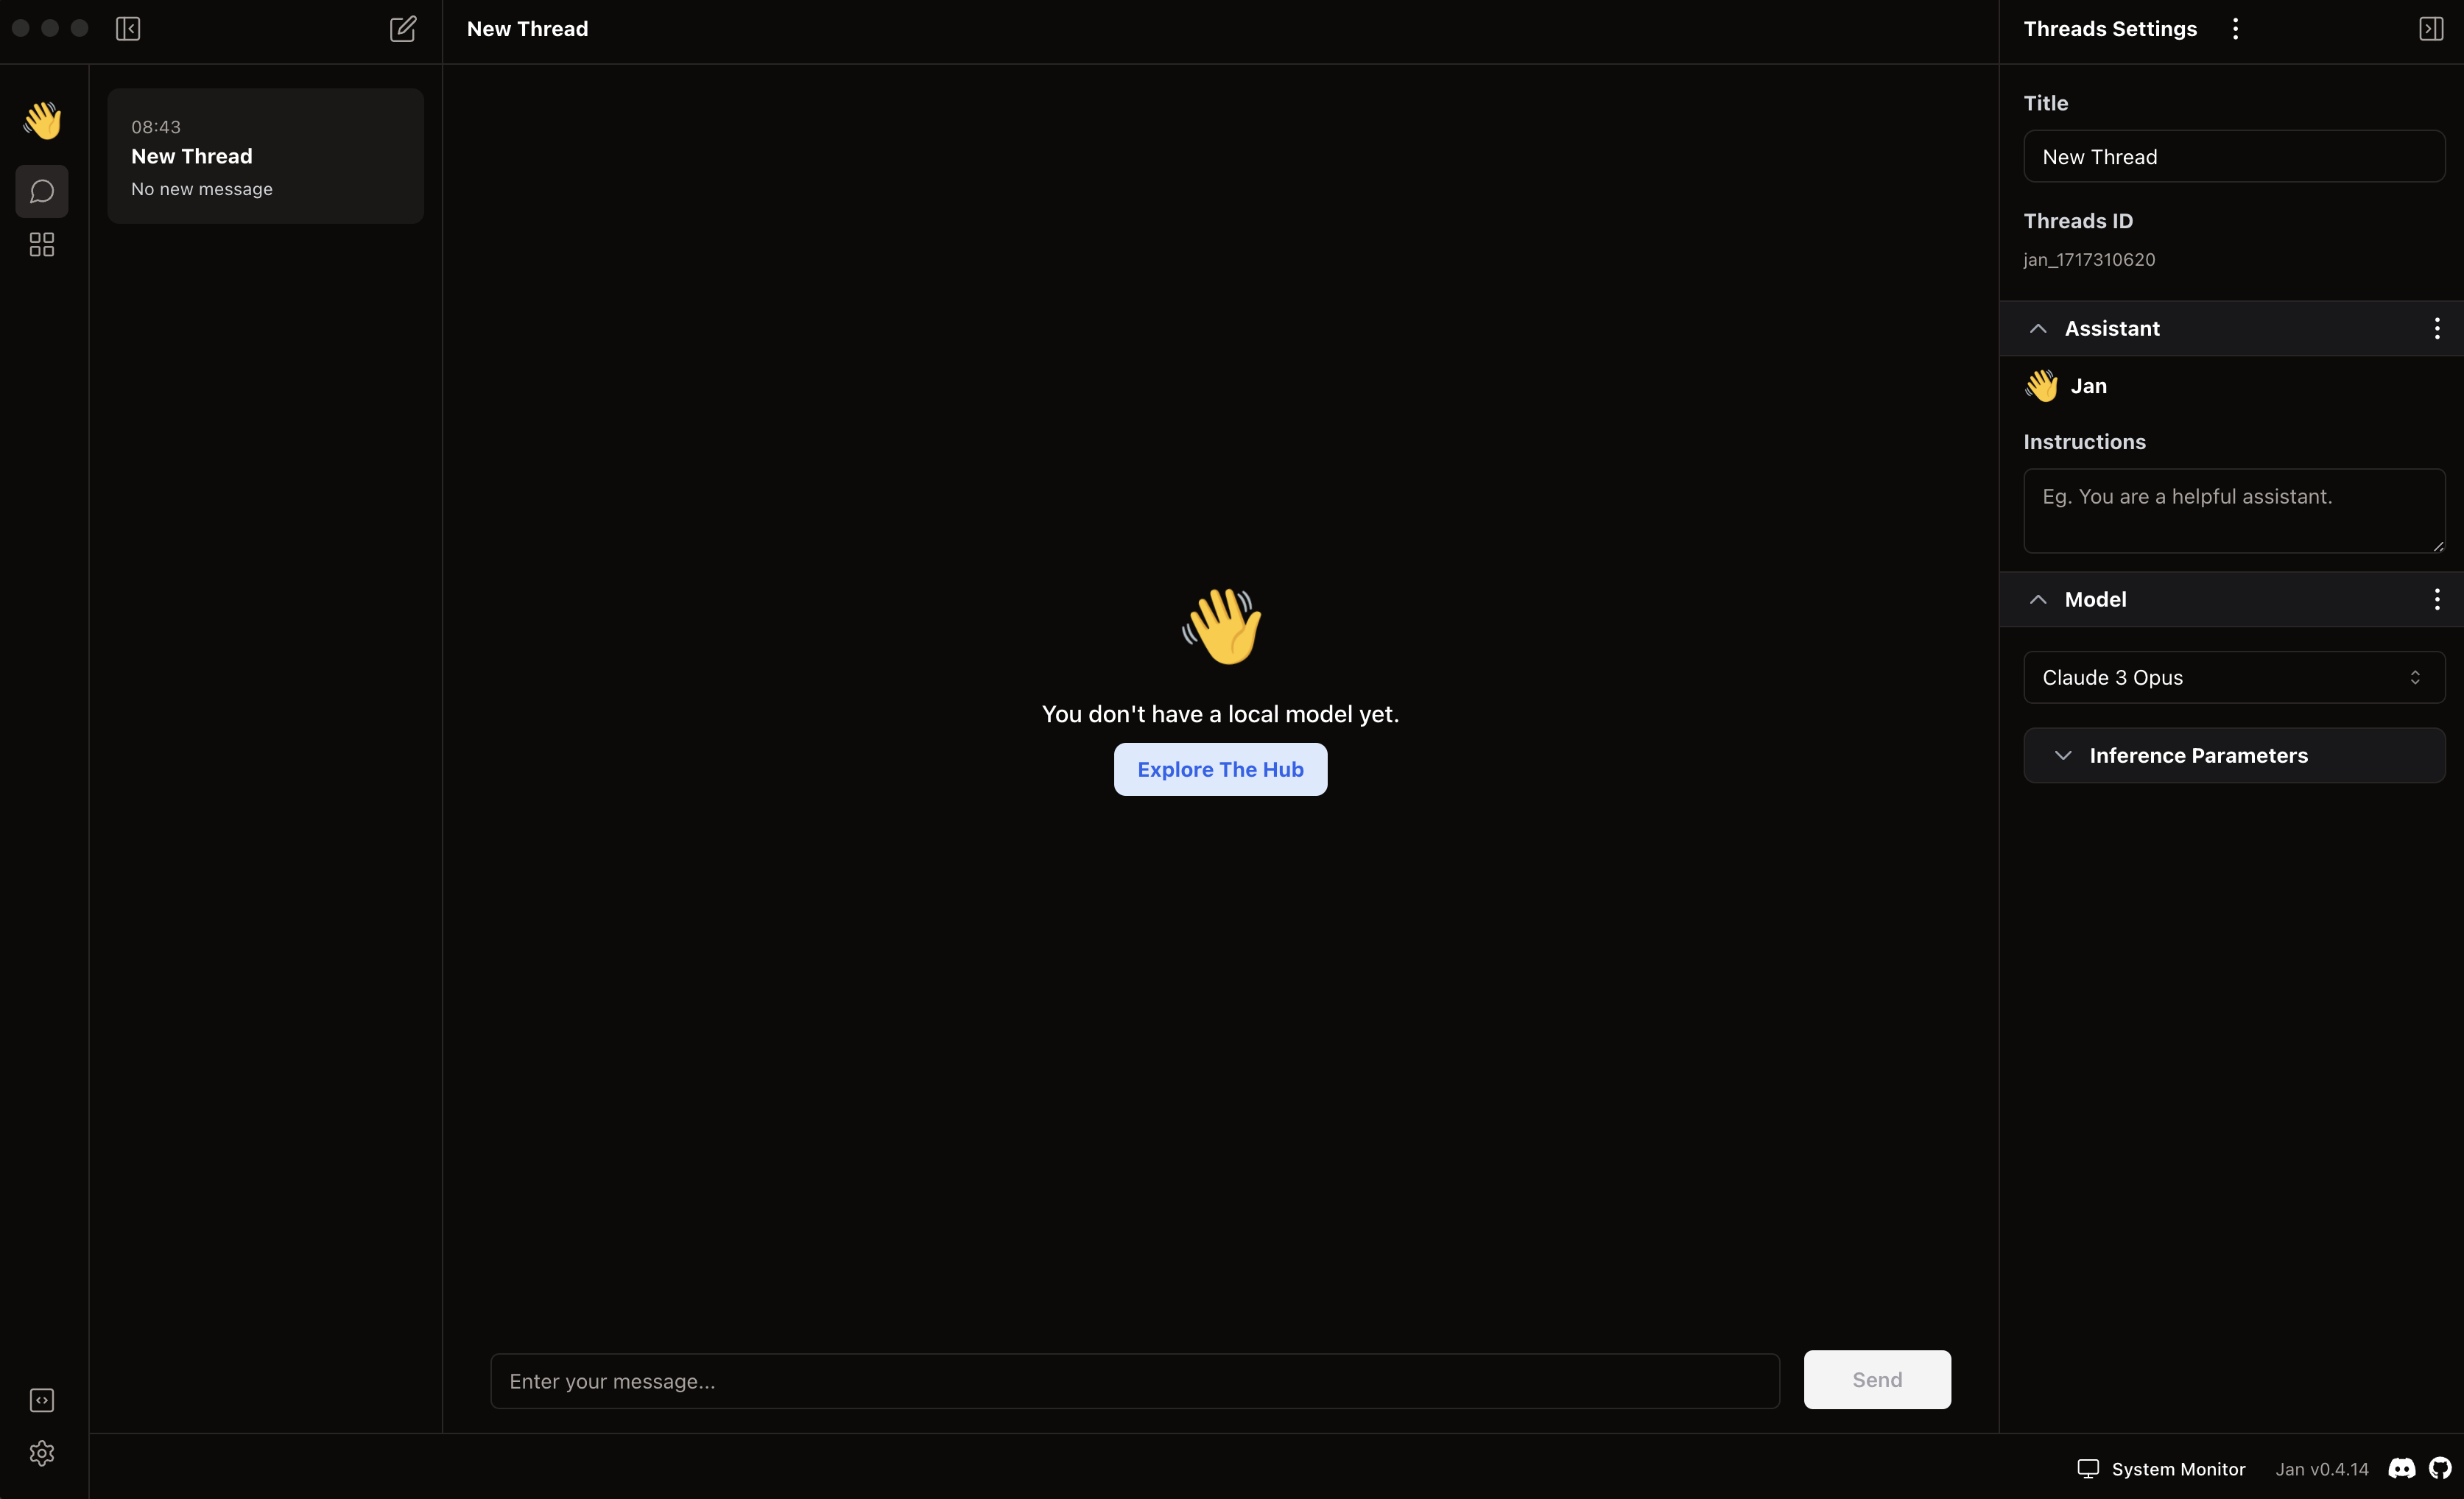
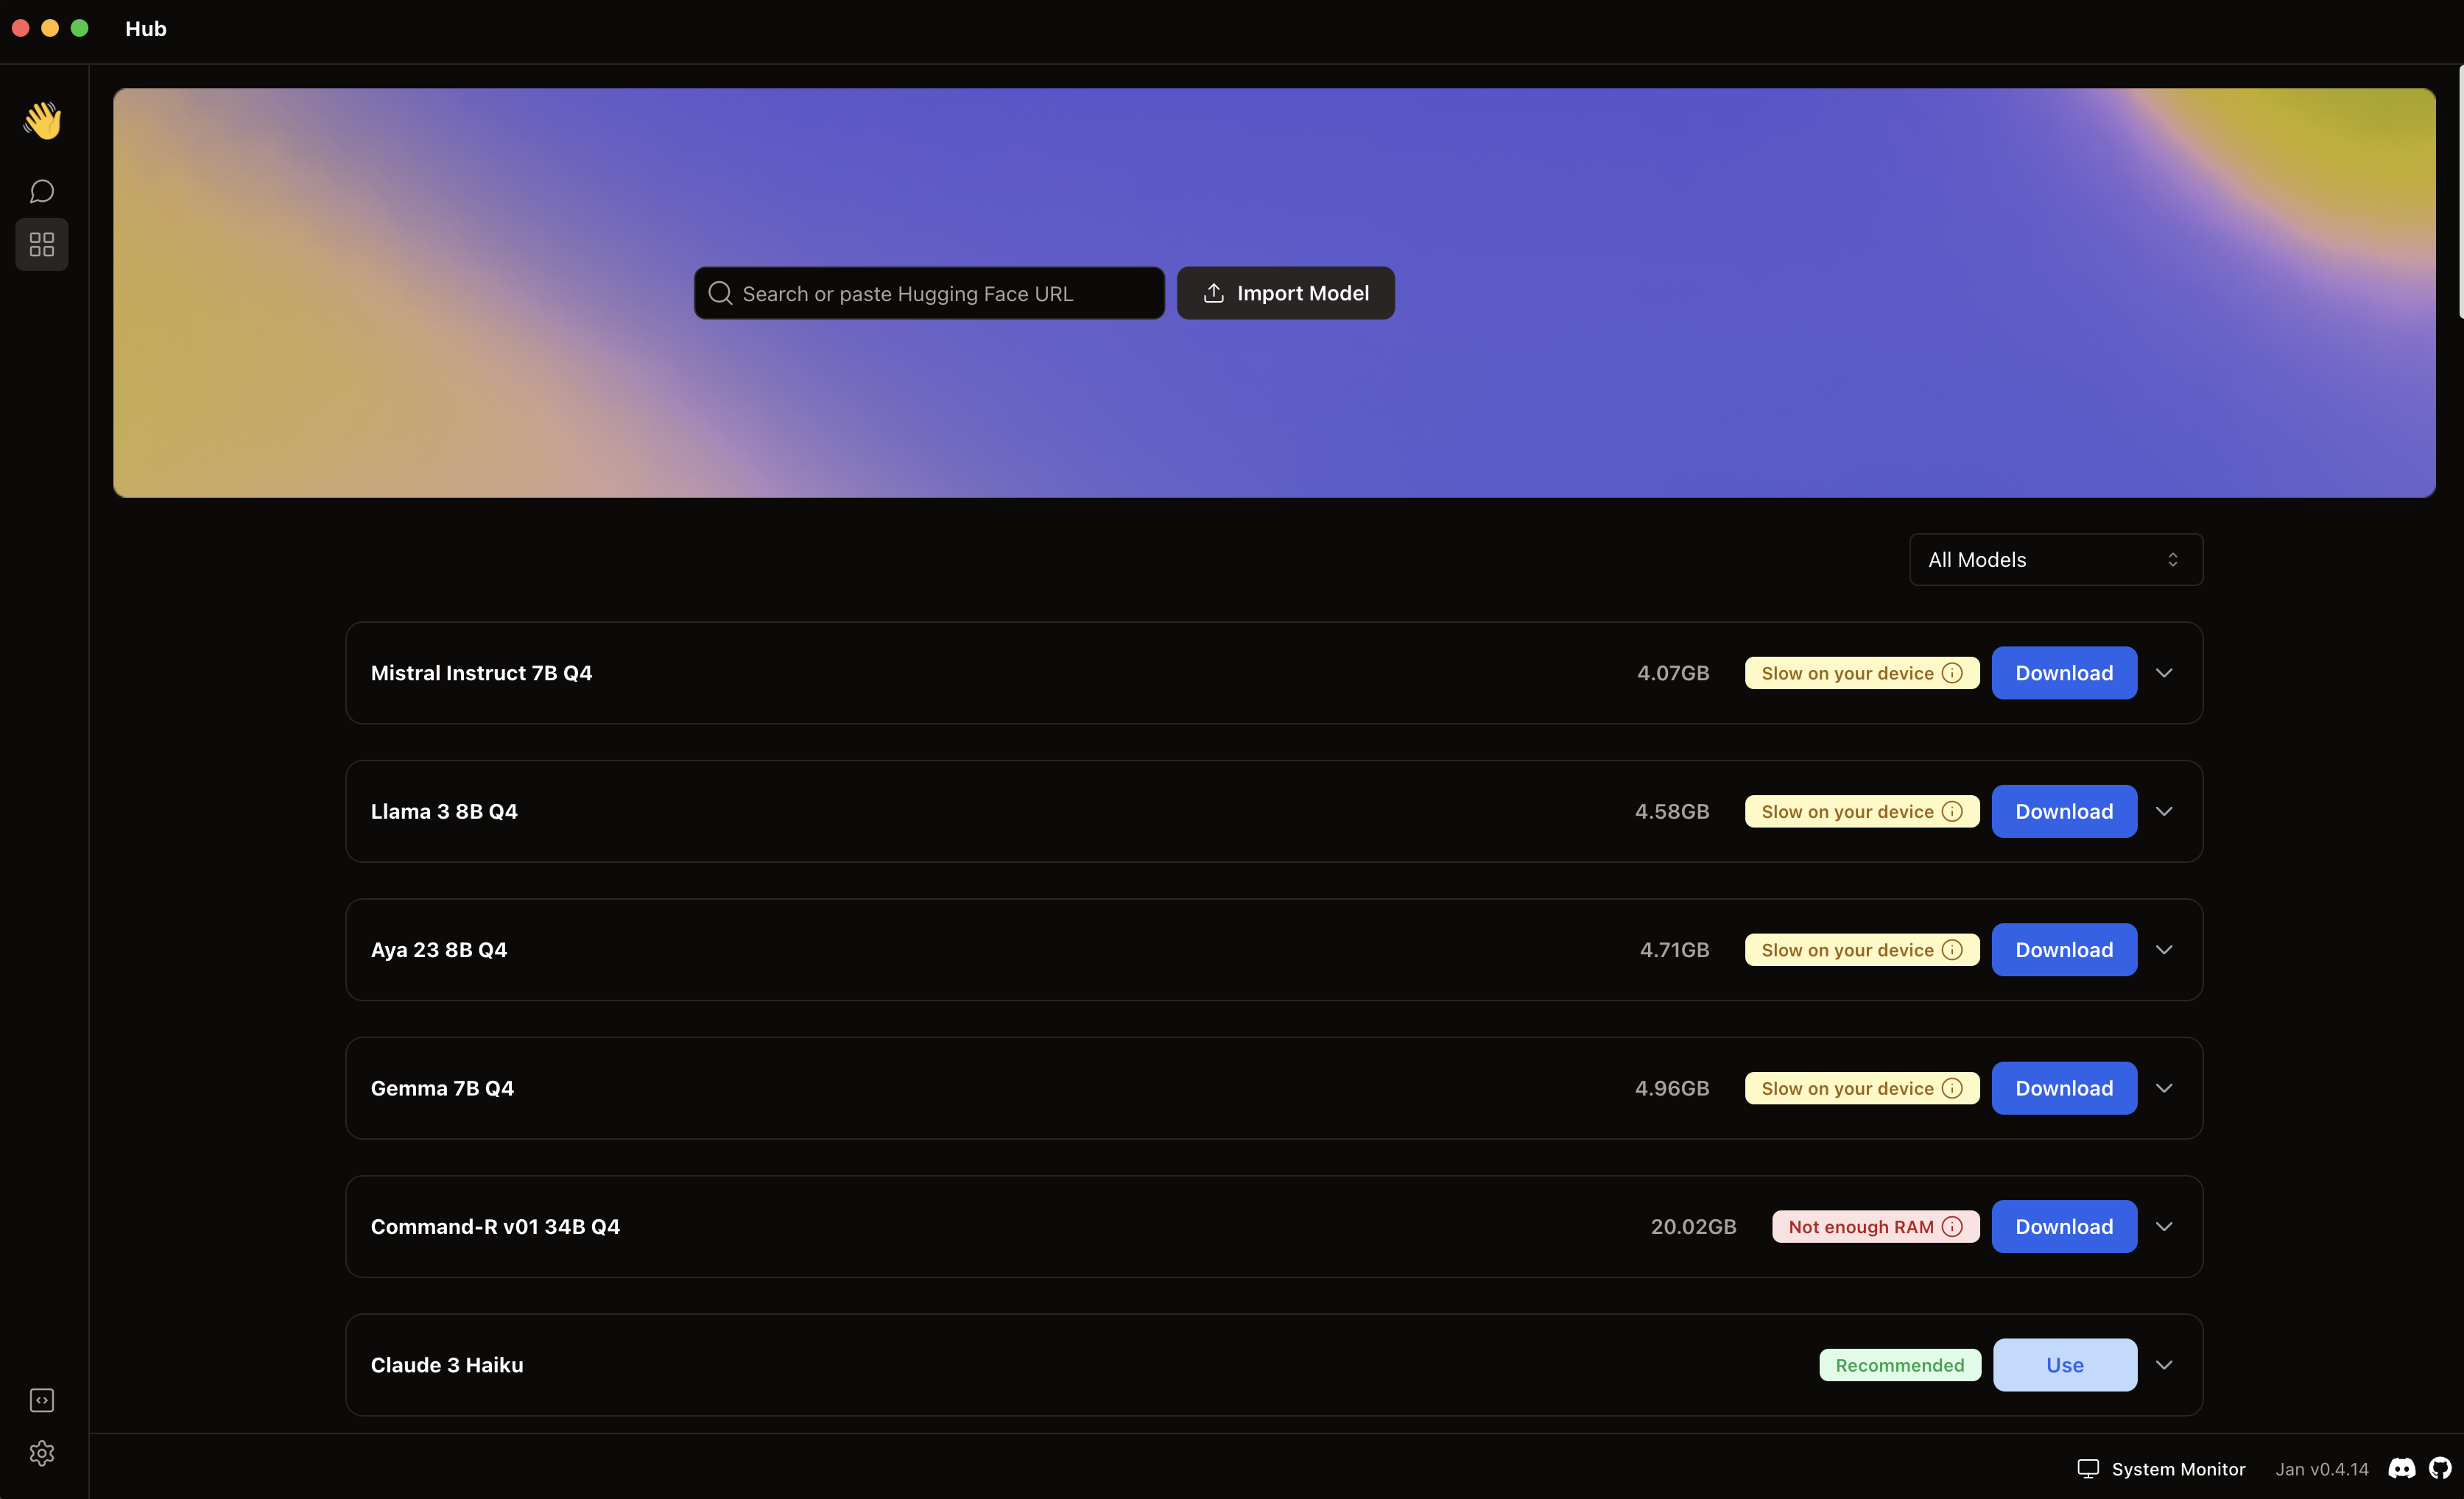
JanAI ist ein OpenSource Projekt, das von der Homebrew Computer Company entwickelt wurde. Es ist ein Programm, welches viele verschiedene Modelle nutzen kann und in einem schönen Interface dem User die Möglichkeit gibt diese Modelle lokal laufen zu lassen. So kann man lokal seinen eigenen ChatBot nutzen, um die Abhängigkeit von z.B. ChatGPT loszuwerden. JanAI ist einfach zu installieren und zu konfigurieren und kann auf jedem System betrieben werden. Dazu zählt Mac OS, Windows und Linux. Außerdem haben wir durch diese OpenSource lösung die Möglichkeit, die AI auf einem Internen Server zu betreiben, der eine API bereitstellt, damit man seine lokalen Modelle auch programmatisch nutzen zu können. Da OpenAIs ChatGPT API wahrscheinlich die bekannteste und meistgenutze ist, haben sich die Entwickler von JanAI dazu entschieden, die API-Endpunkte gleich zu gestalten, dass der wechsel auf lokale Modelle nahtlos läuft.
Die Modelle, die man in JanAI nutzen kann, können entweder einfach über einen lokalen Pfad angegeben werden, wenn man die Modelle sowieso schon installiert hat. Der einfachere Weg ist aber die Verbindung zu huggingface.co nutzen. Das ist eine Community, in der sehr viele verschiedene Modelle schon hochgeladen wurden. Auch große Firmen, wie Meta, Nvidia und Apple nutzen die Plattform, um dort ihre offenen Modelle bereitzustellen.
5.3.1. JanAI Server Installation
Wie bereist erwähnt, bietet JanAI auch die Möglichkeit, die AI Modelle auf einem lokalen Server zu betreiben. Danach haben die Developer sofort die Möglichkeit direkt von ihrer Anwendung darauf zuzugreifen.
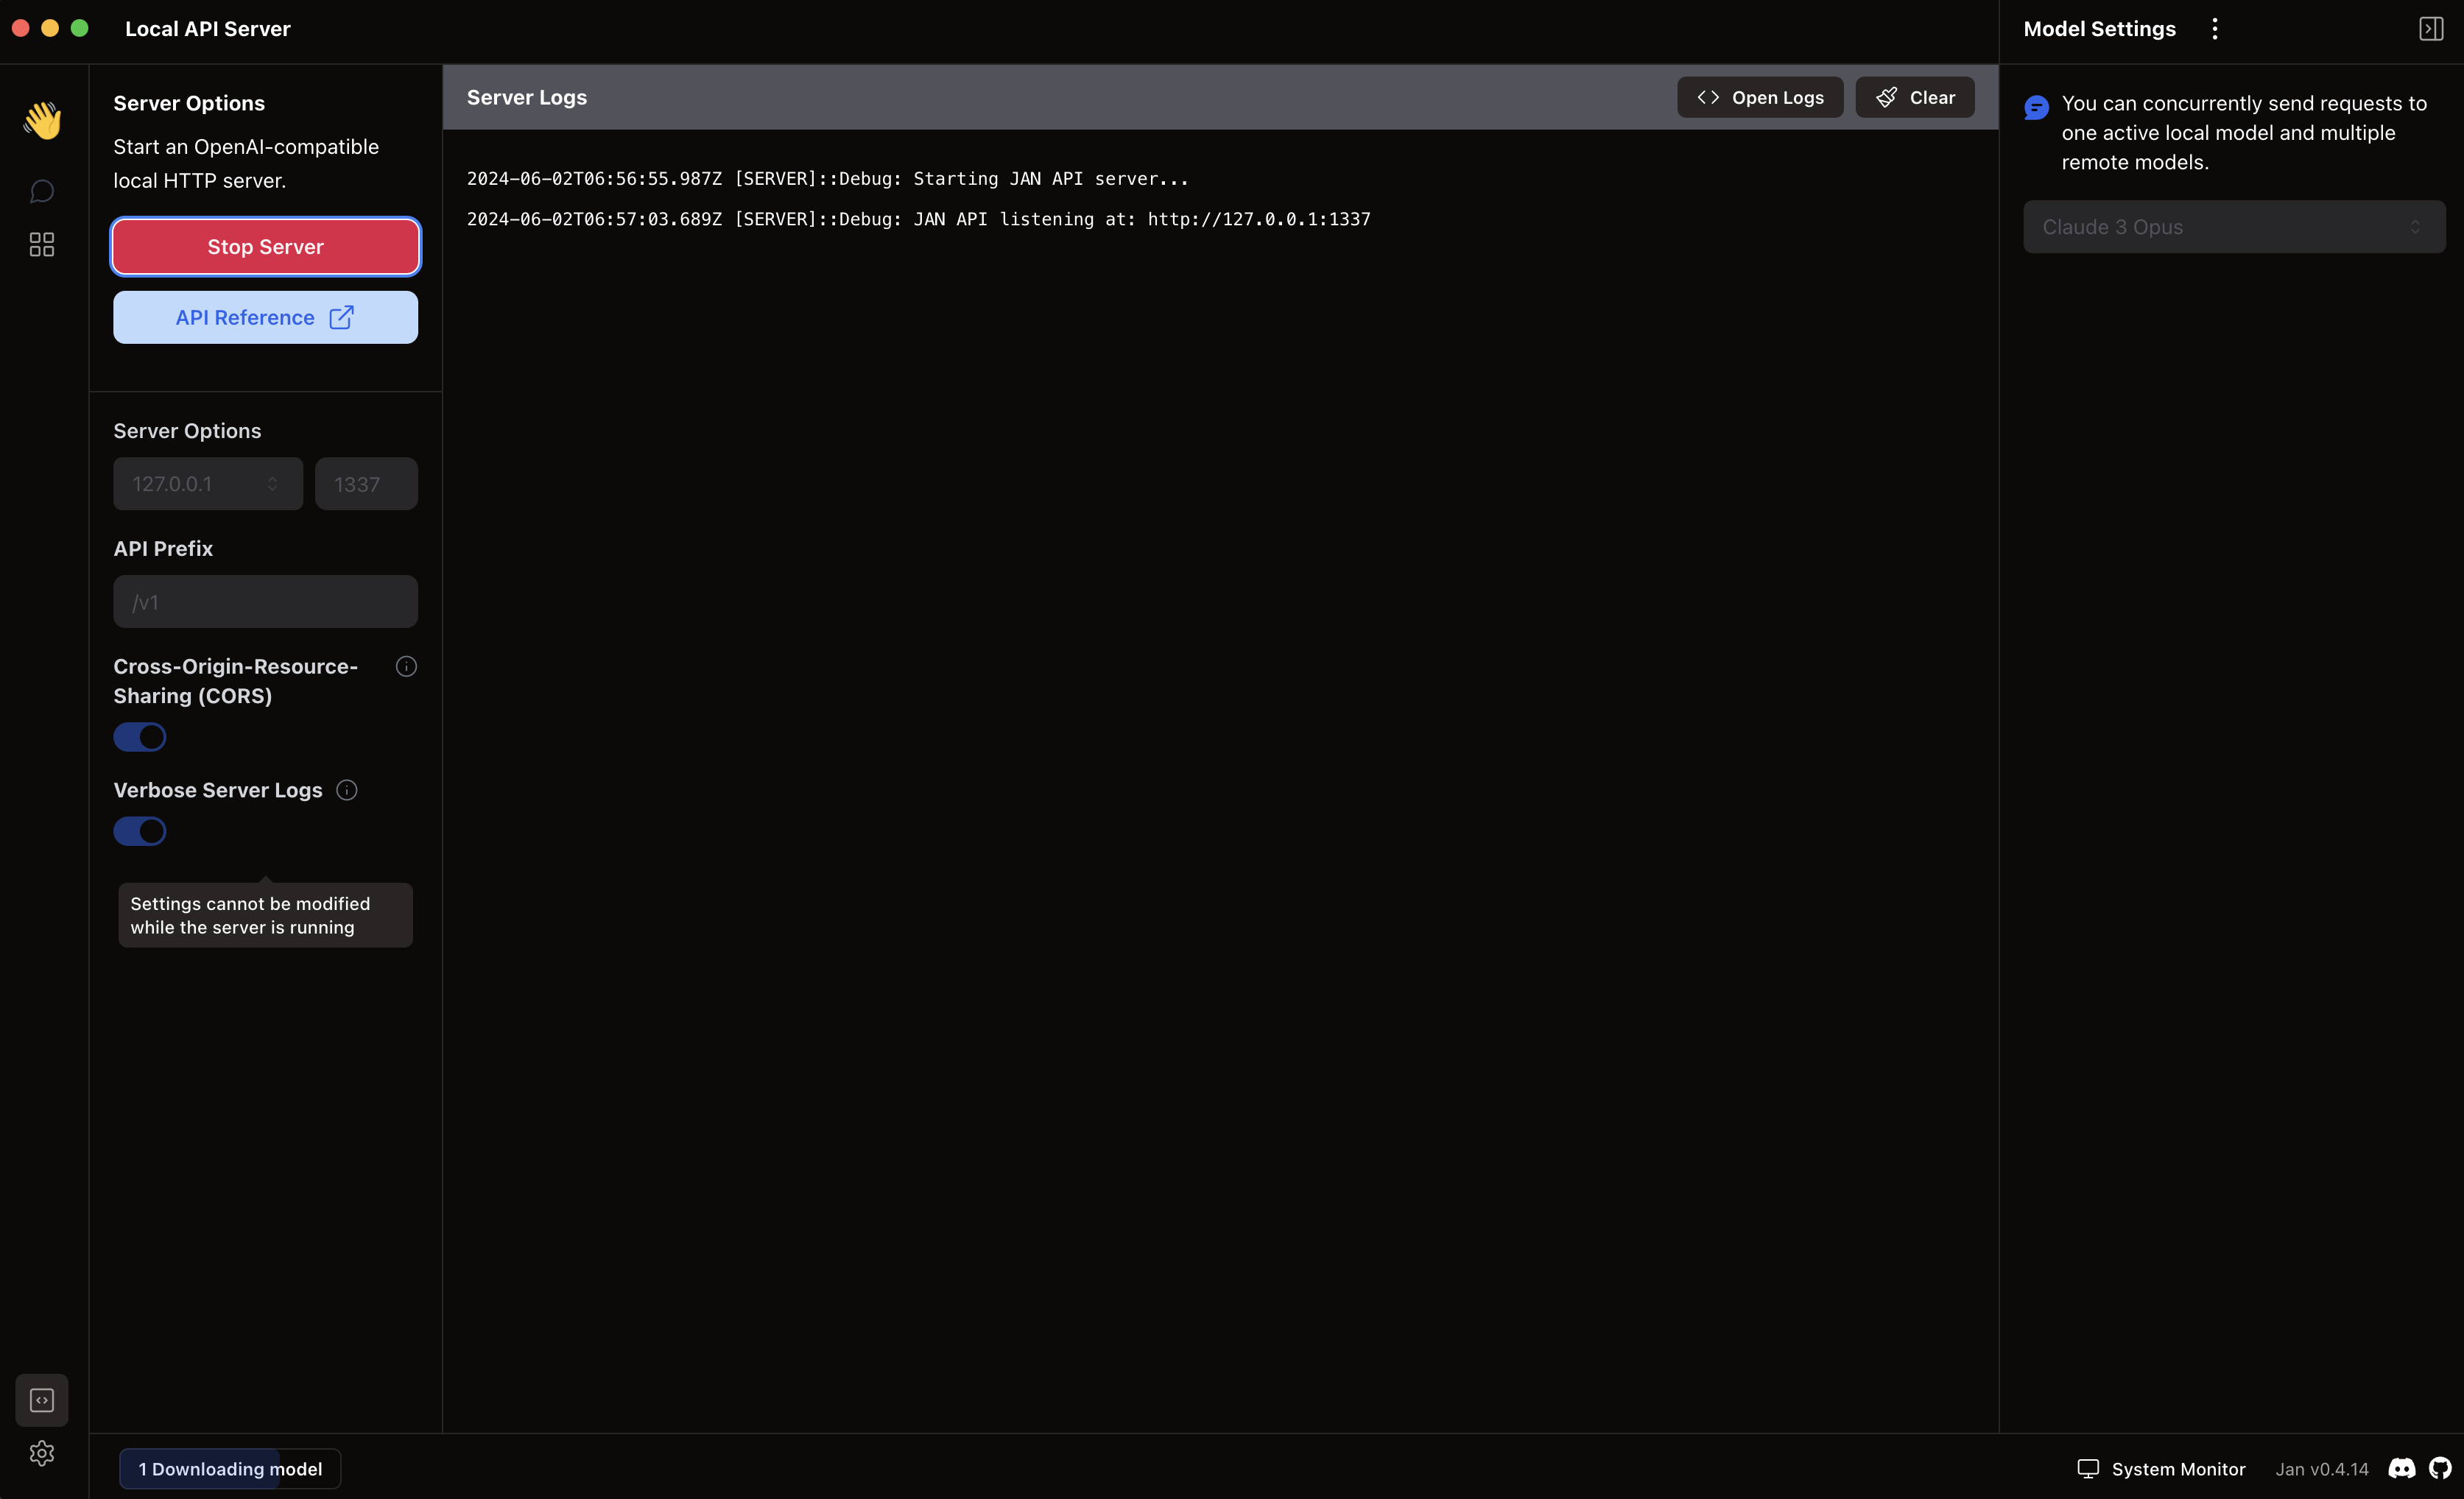
In diesem Bild kann man gut die einfache Konfiguration des Servers erkennen. Durch die Server Options kann man IP und Port des Servers festlegen. Zudem kann man einen API Prefix festlegen, um die API besser zu schützen. Wenn man diesen Startet, wird entsprechend des ausgewählten Modells die API gestartet und ist über den Browser erreichbar mit den angegebenen Adresse.
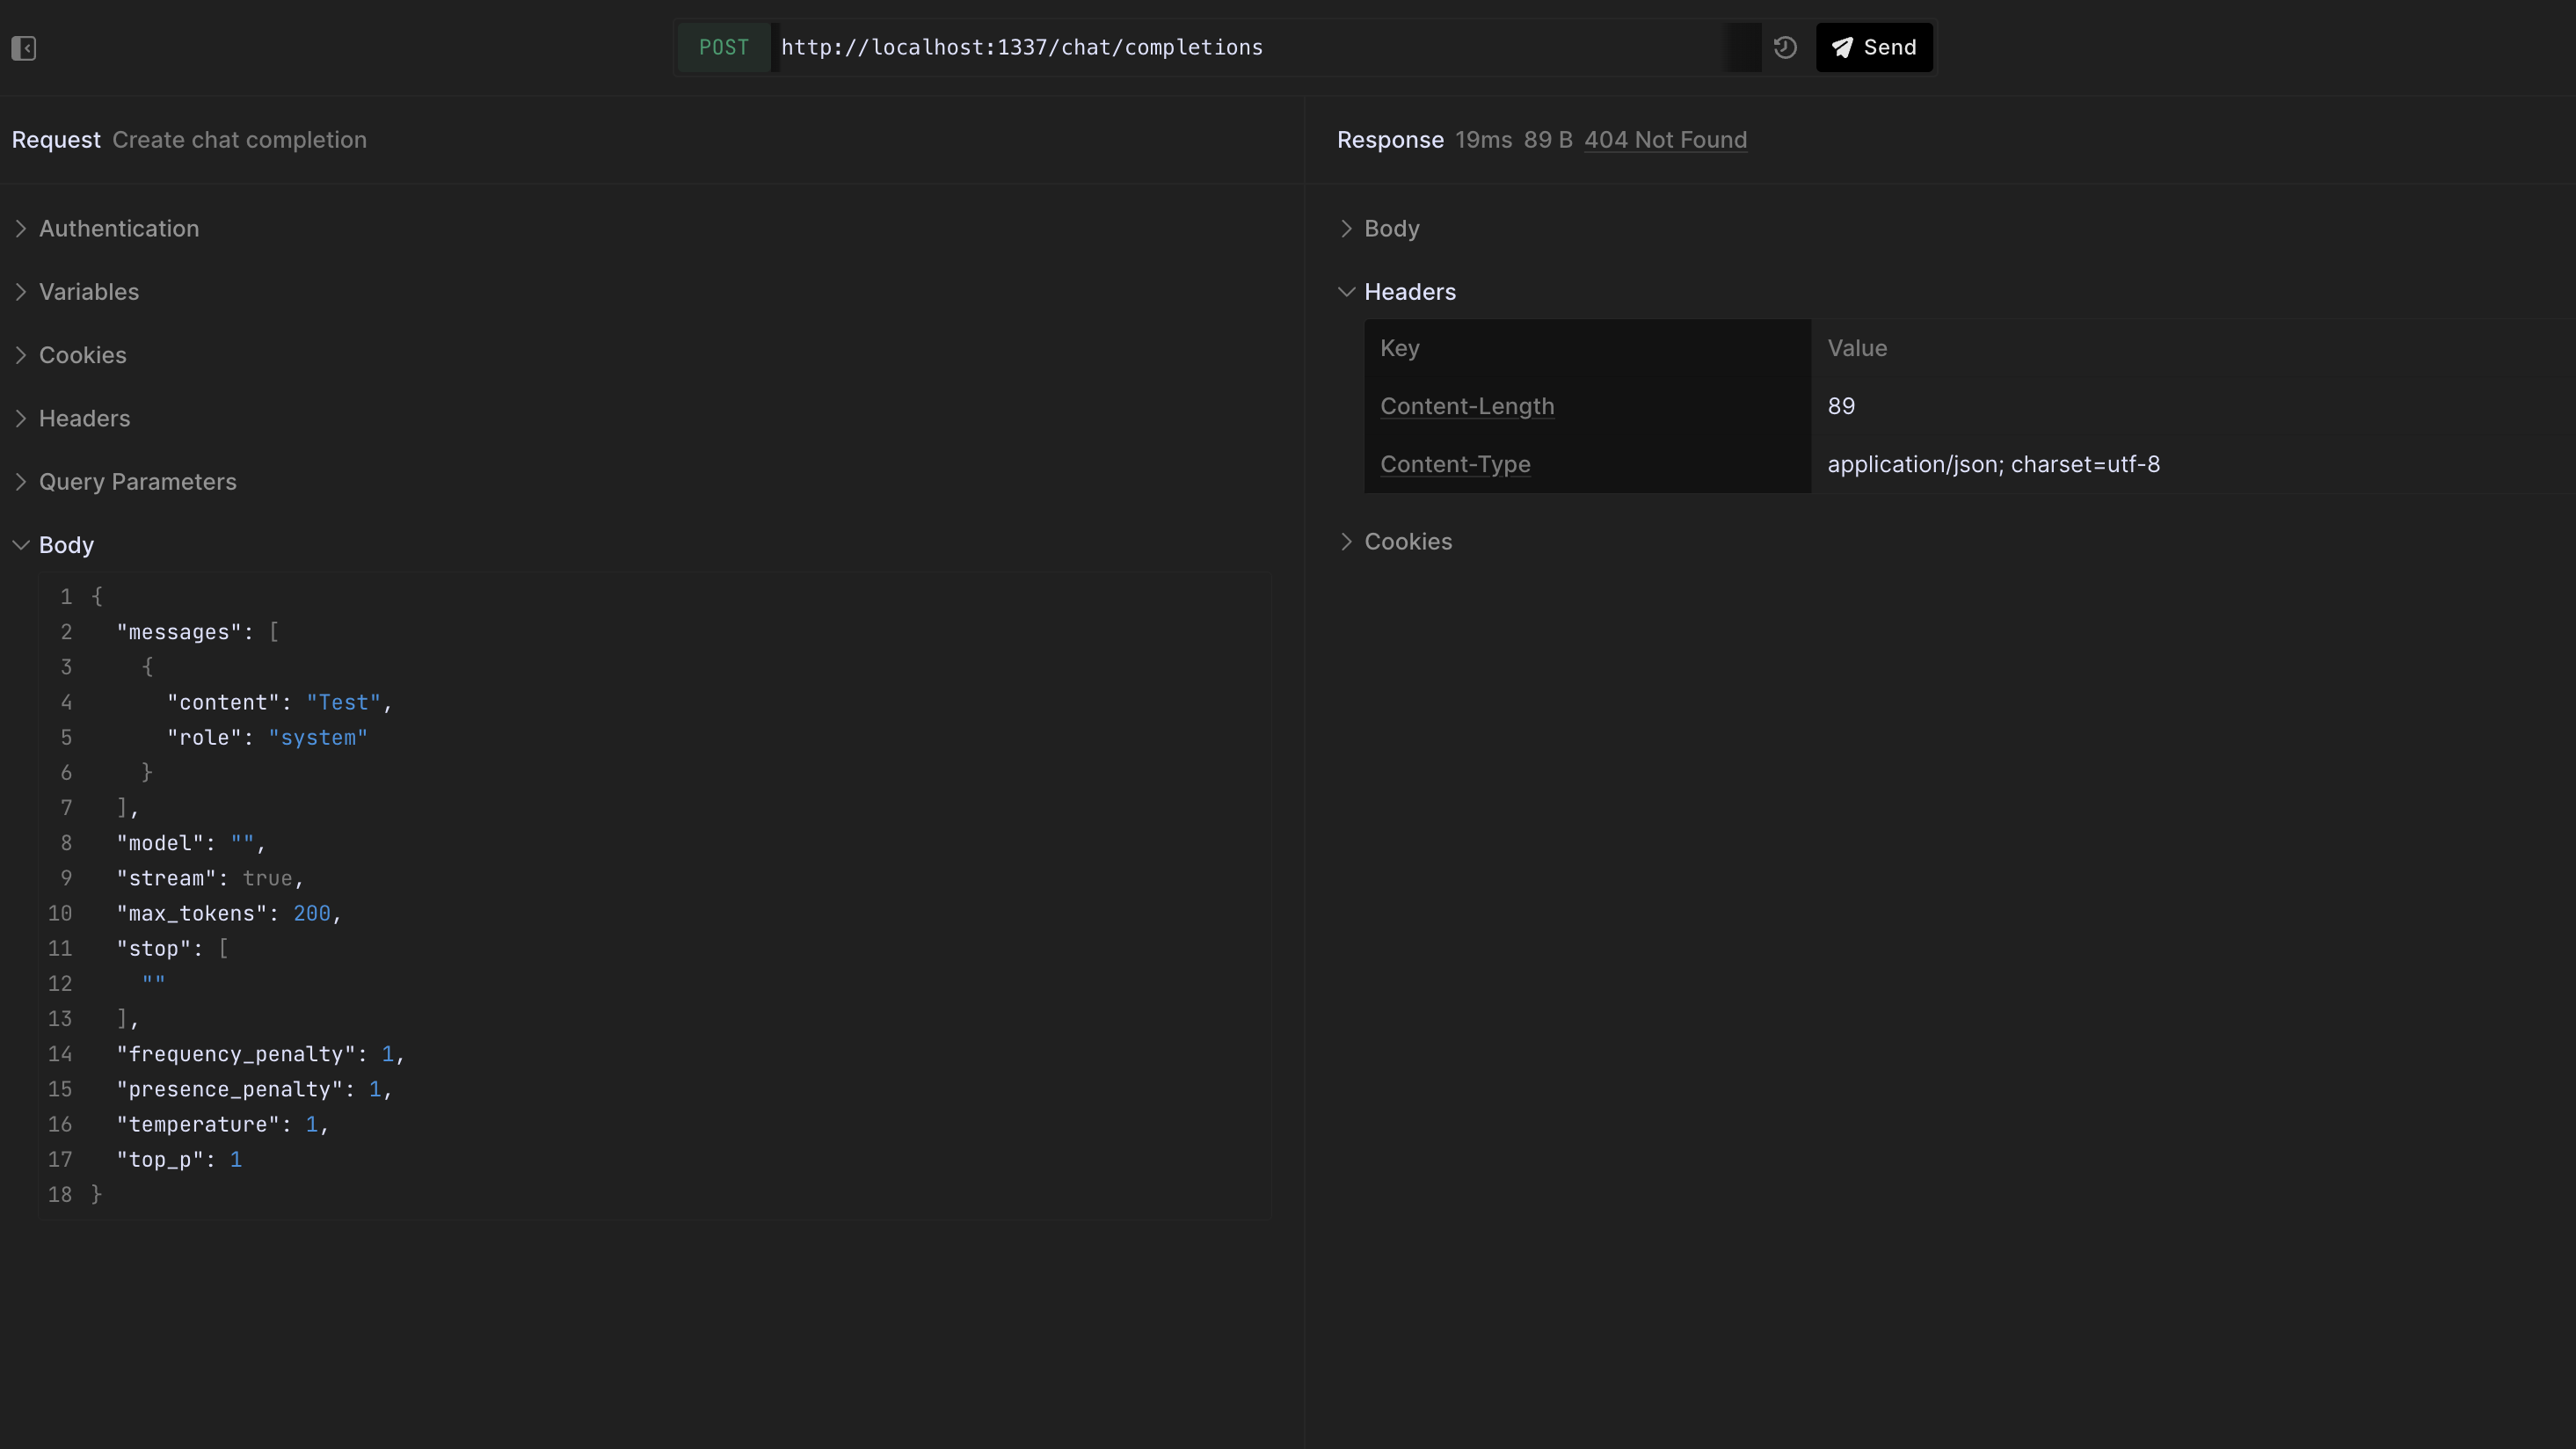
In der Browser Ansicht ist jedoch zu sehen, dass eine viel detailiertere Konfiguration möglich ist. Hierbei kann man zusätzlich eine Authentication mit eine API key festlegen. Außerdem können Variablen und Cookies hinzugefügt werden. Am wichtigsten ist jedoch der Body. Dort wird zum einen die Message übergeben. In diesem ist die Frage, die man der AI schlussendlich stellt. Dort kann man auch die Anzahl der Tokens festlegen. Diese Tokens sind dafür verantwortlich, wie lang die Antwort des Modells wird.
5.3.2. Vergleich zwischen ChatGPT und Llama Modell
Um die Leistung von Llama zu bewerten, haben wir einen Vergleich zwischen ChatGPT und Llama durchgeführt. Hierfür haben wir die beiden Modelle auf die gleiche Anfrage getestet und die Ergebnisse verglichen. Dabei haben wir festgestellt, dass Llama in der Lage ist, präzise und relevante Antworten zu liefern, die mit denen von ChatGPT vergleichbar sind. Inhaltlich sind beide Aussagen nicht falsch. Nur bei Llama sind Antworten, wie auf die Frage „Was bedeutet es, ein erfülltes Leben zu führen?“, deutlich detailierter und informatiever als bei ChatGPT. Das heißt, es rentiert sich auf jedenfall für jeden, mal verschiede Modelle zu testen, um rauszufinden welches das beste für die persönlichen Ansprüche ist.
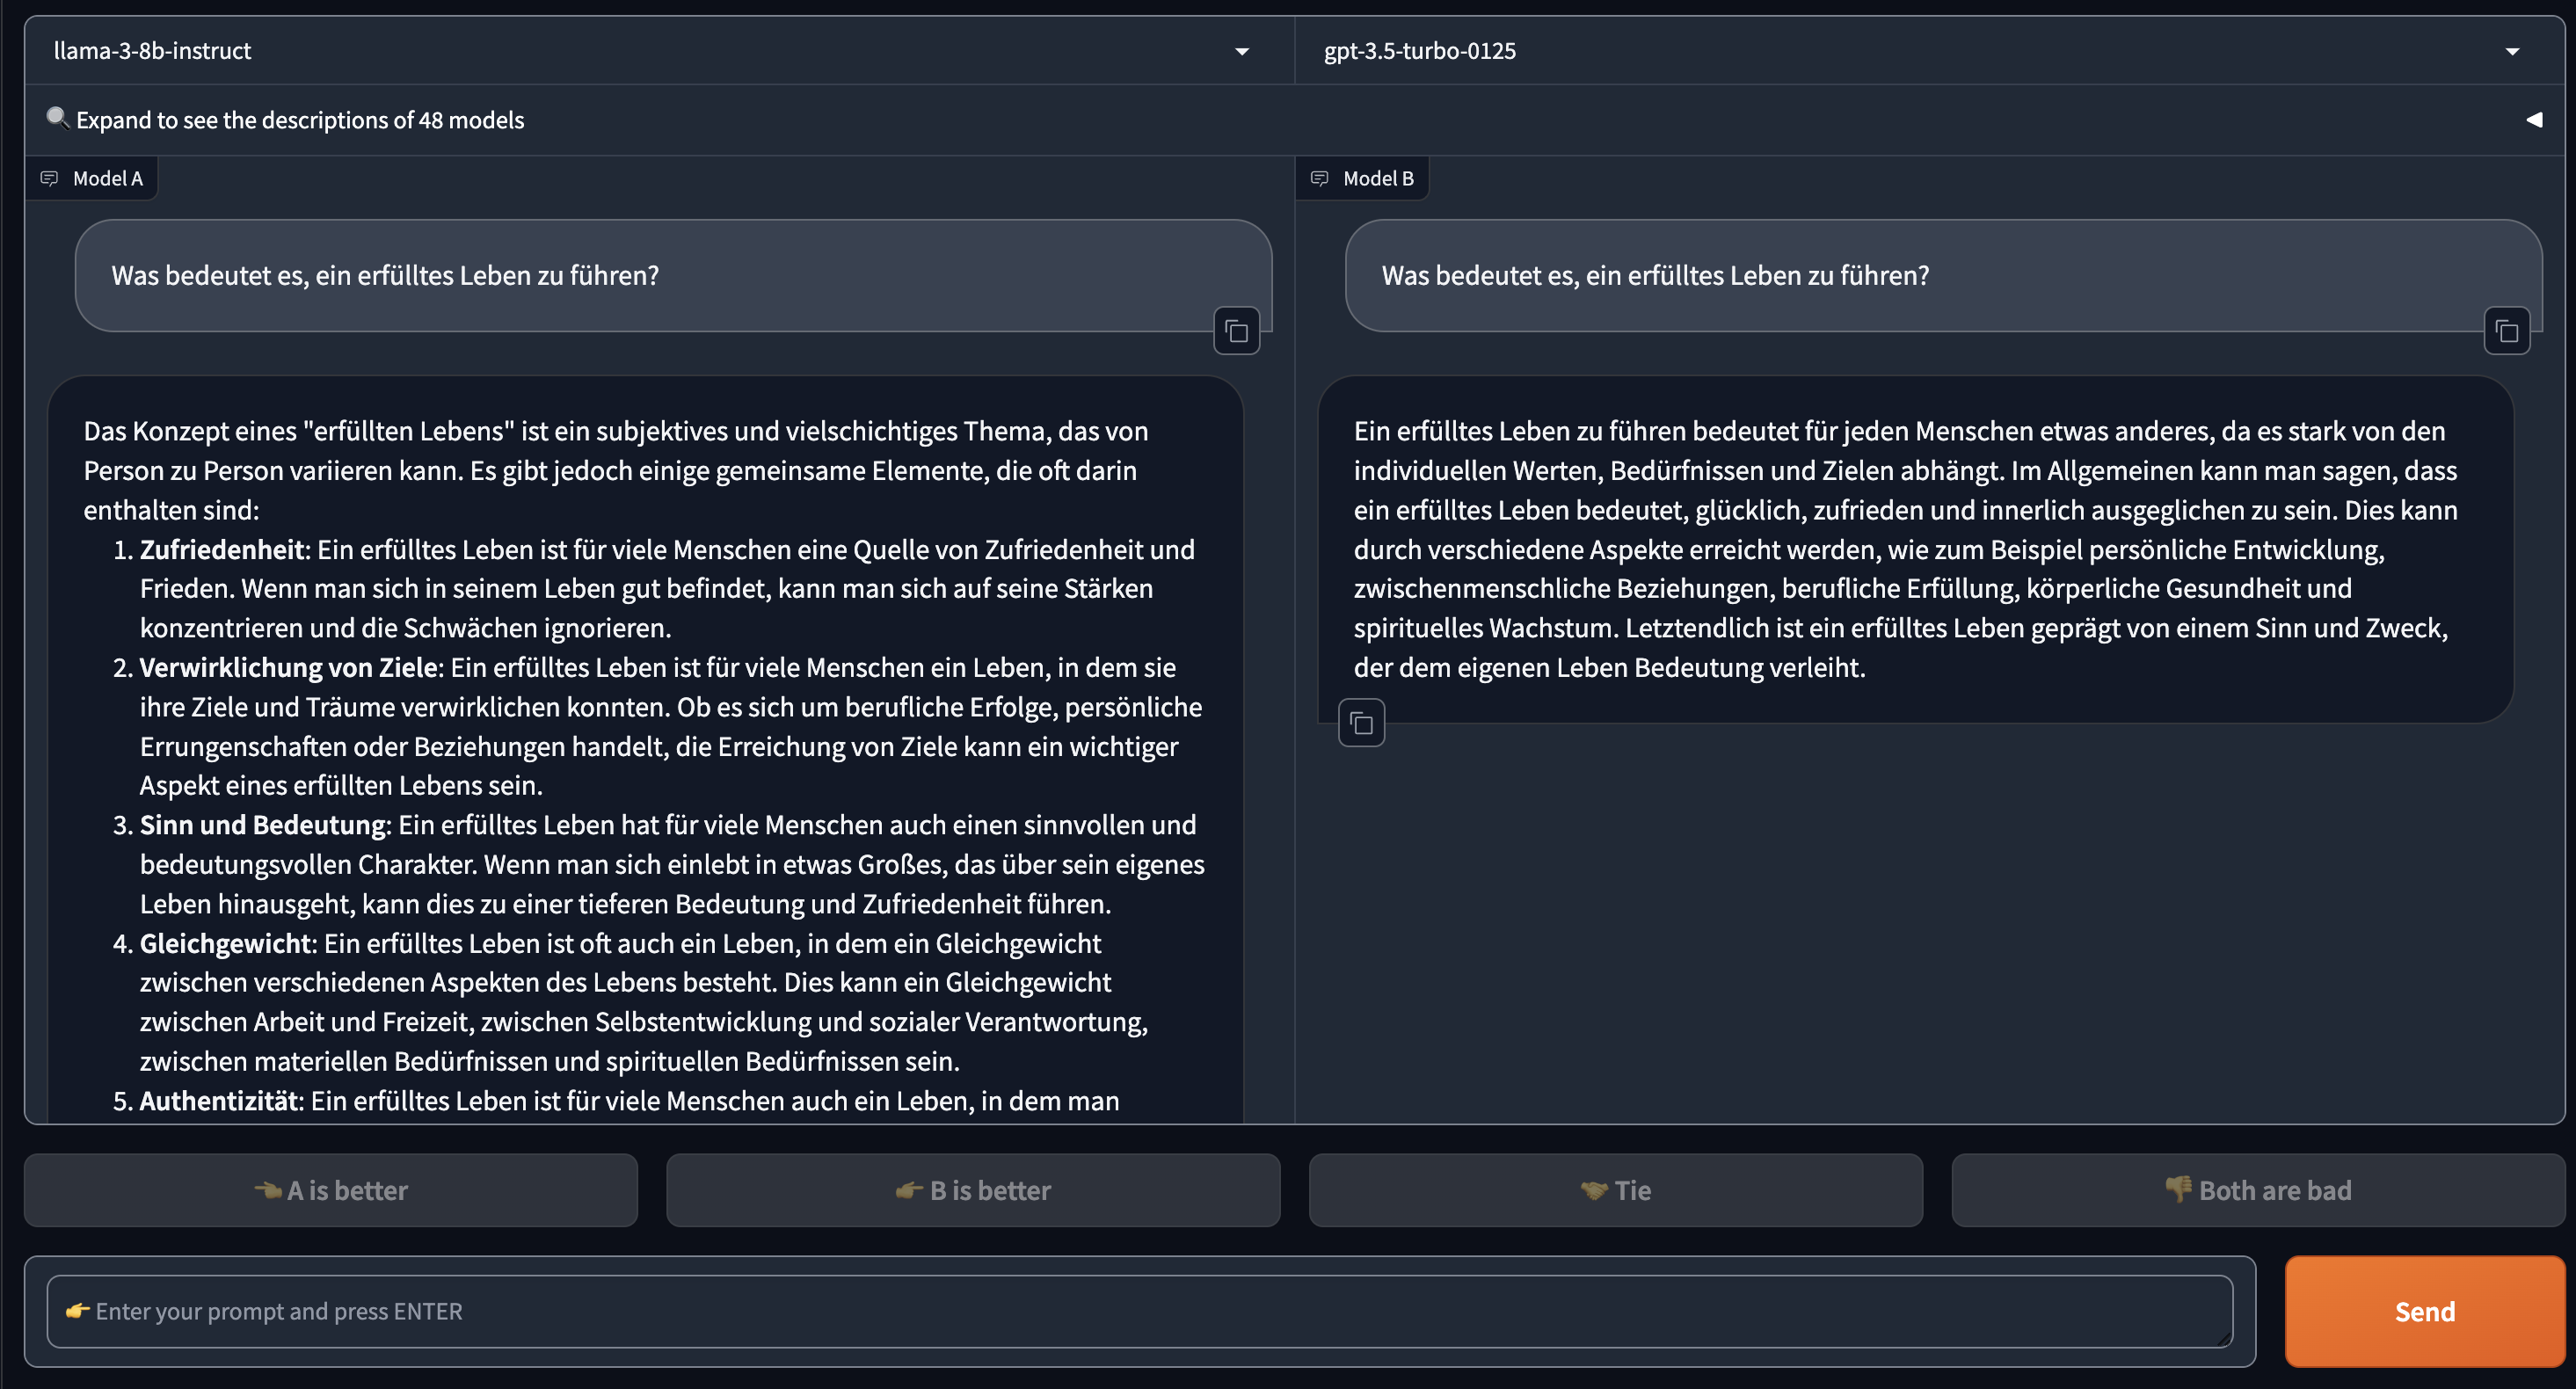
Für den Verlgeich gibt es zudem noch viele Analysen, die Bereits von der LMSYS ORG durchgeführt wurden. Die Large Model System Organisation arbeitet und entwickelt an vielen offenen und frei zugänglichen AI Projekten. Dabei haben sie auch eine Art ChatBot-Arena entwickelt. In dieser Arena kann man die verschiedenen Modelle testen und vergleichen. Dabei ist am ende wichtig, wie man, als Benutzer, dann die Modelle bewertet. Dadurch konnten aus vielen Nutzertests die besten oder auch die schlechtesten Modelle ermittelt werden.
Hiervon gibt es auch eine Leaderboard, auf dem die besten Modelle gelistet sind. Die Bewertung wird aus den Arena Kämpfen ermittelt und hat mit über 1 Milionen Datenpunkten eine sehr starke Aussagekraft. Man erfährt auf der Seite auch, von welcher Organisation das Modell stammt und welche Art von Lizenz sie hat.
Innerhalb dieser Liste erkennt man das unser Modell Llama-3, mit einer Parametergröße von 70B, auf Platz 11 und mit 8B Größe auf Rang 22 ist. Das Ergebnis ist für ein relativ kleines Modell ein echt gutes Ergebnis und hat uns sehr positiv überrascht.
5.3.3. Ergebnisse
Durch das beschäftigen mit Llama und JanAI haben wir festgestellt, das es teilweise schwierig sein kann, eine AI auf dem eigenen Rechner zu betreiben. Jedoch gibt es heutzutage viele coole OpenSource Projekte und Plattformen, die es ermöglichen, ein AI Modell einfach und effektiv lokal zu betreiben. Zudem ist es wichtig sich mit den Grundlagen von AI und LLMs vertraut zu machen, um diese effektiv nutzen zu können. Mit JanAI haben wir eine sehr guten kompromiss zwischen Funktionalität und einfacher Einbindung gefunden, die es ermöglicht auch auf einem eigenen Servern eine AI zu managen.
5.3.4. Fazit
Wir haben festgestellt, das es teilweise schwierig sein kann, eine AI auf dem eigenen Rechner zu betreiben. Hierbei werden die Richtigen Voraussetzungen benötigt, wie z.B. eine genug Arbeitsspeicher, genügend Speicherplatz und eine gute GPU. Außerdem ist es wichtig, sich mit den Grundlagen von AI und LLMs vertraut zu machen, um die AI im Alltag effektiv nutzen zu können. Das viele Testen und Recherieren hat uns aber gezeigt, das es endlose Möglichkeiten gibt, ein AI Modell auf dem eigenen Rechner zu betreiben. So haben wir mit JanAI eine, für uns, sehr gute Lösung gefunden, dies zu ermöglichen. Die Leistungsfahigkeit, von selbst kleinen Modellen hat uns positiv überrascht. Um das beste für seinen Anwenungsfall zu bekommen, ist es wichtig, sich mit den verschiedenen Modellen auseinanderzusetzen, und sich über aktuelle Entwicklungen zu informieren.
5.4. Literaturangaben
[1] https://github.com/meta-llama/llama3
[2] https://llama.meta.com/llama-downloads/
[3] https://pytorch.org/get-started/locally/
[4] https://jan.ai
[5] https://jan.ai/api-reference#tag/inference/post/chat/completions
[6] https://github.com/janhq/jan/
[7] https://huggingface.co/spaces/lmsys/chatbot-arena-leaderboard