6 LLM mit Retrieval Augmented Generation (RAG)
6.1 Einleitung
In diesem Mini-Projekt wurde ein Retrieval-Augmented Generation (RAG) System entwickelt und getestet. Das System kombiniert ein Large Language Model (LLM) mit einer Vektordatenbank, um kontextbasierte Antworten zu generieren. Zusätzlich wurde ein Klassifikator trainiert, der erkennt, ob ein Nutzer den Wunsch äußert, neue Informationen zu speichern.
6.2 Vektordatenbank
6.2.1 Wikipedia-Downloader und Embedding-Prozess
Die Datei fill_db_wikipedia.py übernimmt das Laden, Vorverarbeiten und Vektorisieren ausgewählter Wikipedia-Artikel. Anschließend werden die Vektoren in einer Chroma-Datenbank gespeichert.
wikis = [
    "Künstliche Intellligenz",
    "Deutscher Bundestag",
    "Bundeskanzler (Deutschland)"
]
Zunächst wird eine Verbindung zur deutschen Wikipedia aufgebaut und die Artikeltexte geladen. Die Texte werden dann in kleinere Abschnitte (“Chunks”) zerteilt:
text_splitter = CharacterTextSplitter(chunk_size=2000, chunk_overlap=50)
doc_splits = text_splitter.split_text(wikitext)
Die einzelnen Textabschnitte werden anschließend mit einem Ollama Embedding-Modell (mxbai-embed-large) in Vektoren umgewandelt und persistent in Chroma gespeichert:
vectorstore = Chroma.from_texts(
    texts=doc_splits,
    embedding=OllamaEmbeddings(model=EMBED_MODEL),
    persist_directory="./test_db",
)
6.3 LLM mit RAG-Integration
Die Datei llm_rag_test.py zeigt die Nutzung des LLM mit und ohne RAG.
6.3.1 Schritt 1: Modelle laden
Zunächst werden das Sprachmodell und das Embedding-Modell heruntergeladen:
models_to_download = [MODEL, EMBED_MODEL]
for model in models_to_download:
    ollama.pull(model, stream=True)
6.3.2 Schritt 2: Anfrage formulieren
Eine Beispiel-Frage wird definiert:
question = "Wer ist der aktuelle Bundeskanzler von Deutschland?"6.3.3 Schritt 3: Beantwortung ohne Kontext
Das LLM erhält die Frage ohne jeglichen zusätzlichen Kontext:
before_rag_template = "Beantworte die folgende Frage: {question}"
before_rag_chain = before_rag_prompt | model_local | StrOutputParser()
Das Modell antwortet allein basierend auf seinem vortrainierten Wissen.
6.3.4 Schritt 4: Beantwortung mit RAG
Für die RAG-Version wird ein Retriever aus der Chroma-Datenbank erstellt. Dieser liefert relevante Dokumente zur gestellten Frage:
retriever = vectorstore.as_retriever()
Diese Dokumente werden dann in den Prompt eingefügt:

after_rag_template = (
    "Beantworte die Frage nur mithilfe des folgenden Kontextes:\n{context}\nFrage: {question}"
)
after_rag_chain = (
    {"context": retriever, "question": RunnablePassthrough()}
    | after_rag_prompt
    | model_local
    | StrOutputParser()
)
Das Modell wird angewiesen, ausschließlich basierend auf dem gefundenen Kontext zu antworten – was für kontrollierbare und aktuelle Antworten sorgen soll.
6.4 Ergebnis
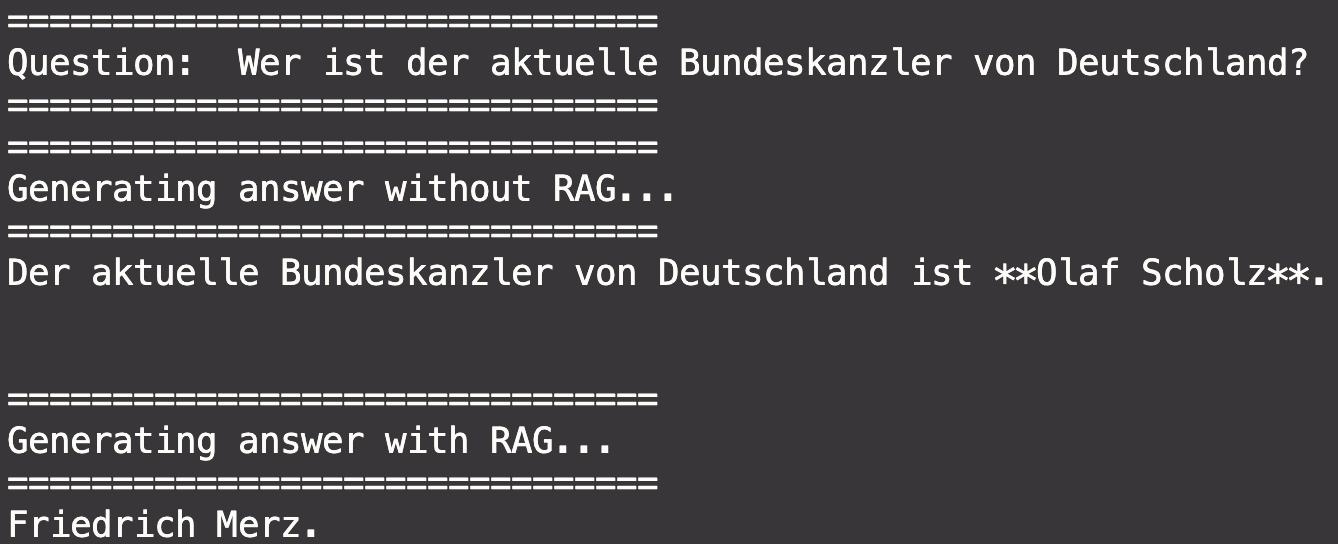
Der Unterschied zwischen der Antwort ohne Kontext und mit RAG ist klar sichtbar. Während das Modell ohne RAG möglicherweise veraltete oder erfundene Informationen liefert, bezieht es sich mit RAG konkret auf den eingebetteten Inhalt der Wikipedia-Artikel.
Beobachtungen: Die Integration der Vektordatenbank führt zu teils zu zuverlässigeren Antworten. Allerdings erkennt das Modell nicht garantiert die richtigen Informationen in den bereitgestellten Texten. Die Performanz hängt stark von der Qualität und Relevanz der eingebetteten Dokumente ab.
6.5 Zusatz: Klassifikator zur Speichererkennung
Die Datei classifier_training.py trainiert ein Klassifikationsmodell basierend auf TinyBERT. Ziel ist es, Nachrichten zu erkennen, die eine Speicheranweisung enthalten könnten (z. B. “Merk dir das” oder “Speichere folgende Information”).
Beispiel Inhalt der Trainingsdaten:
"Bitte speichere folgende Information: Mein Name ist Max Mustermann.",1
"Merke dir bitte: Ich wohne in der Musterstraße 123.",1
"Füge den Kontakt 'Anna Schmidt' in meine Datenbank ein.",1
...
"Wie funktioniert ein Elektromotor?",0
"Erzähle mir etwas über Albert Einstein.",0
"Was sind die Hauptstädte der europäischen Länder?",0
...
6.5.1 Trainingsprozess
- Laden von CSV-Daten mit Labeln (0 = keine Speicheranweisung, 1 = Speicheranweisung).
- Tokenisierung mit AutoTokenizer.
- Training mit dem Trainer-Interface von Huggingface.
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["validation"],
    compute_metrics=compute_metrics,
)
Nach dem Training wird das Modell gespeichert und kann direkt in einer pipeline genutzt werden:
classifier = pipeline("text-classification", model=output_dir, tokenizer=output_dir)
result = classifier("Wie ist das Wetter")
print(result)
6.5.2 Anwendung
Der Klassifikator kann in ein Dialogsystem integriert werden, um dynamisch zu erkennen, ob Nutzereingaben gespeichert werden sollen – eine wichtige Funktion für interaktive Systeme mit Langzeitgedächtnis.
6.6 Alternativ: Web-UI zum Ausführen des Scripts
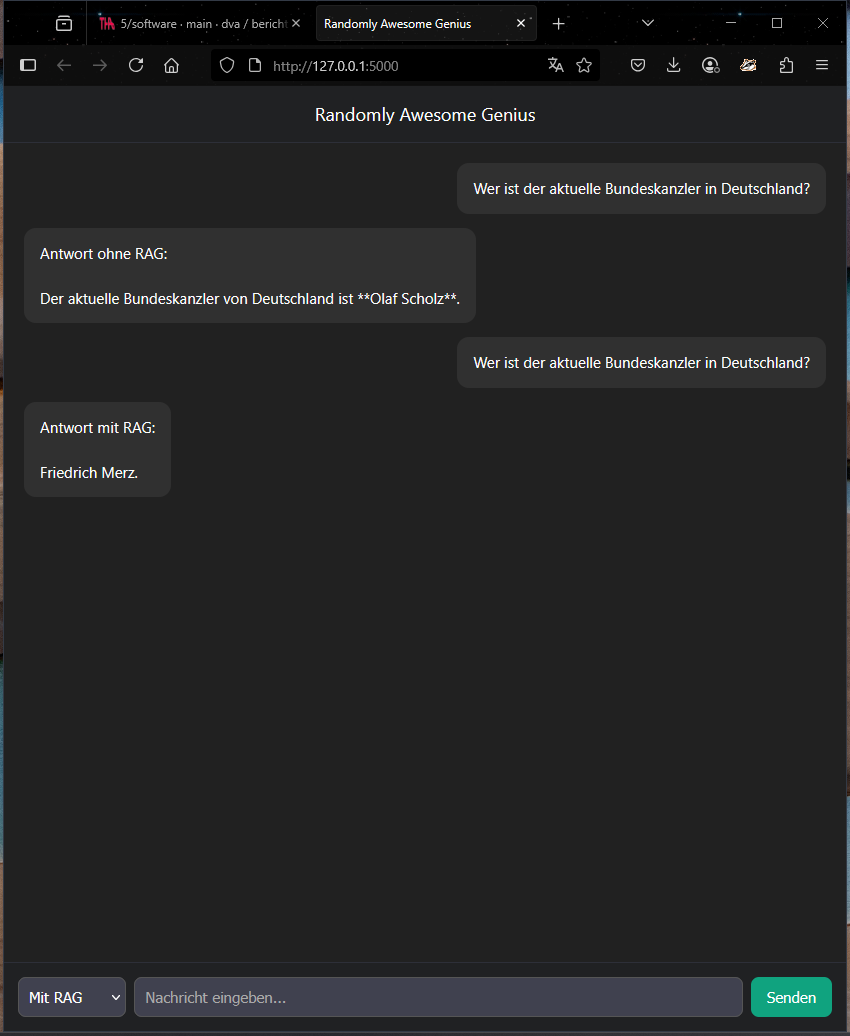
Die Web-UI besteht aus einer einfachen HTML-Seite mit Chat-Oberfläche und einem Flask-Backend. Nutzer:innen können eine Nachricht eingeben und optional zwischen der Verwendung von RAG („mit“ oder „ohne“) wählen. Die Nachricht wird per POST an das Backend gesendet (/chat), das anschließend das Python-Script run_llm.py aufruft und dessen Ausgabe direkt zurückgibt. Die Antwort erscheint dann im Chatfenster im Browser.
6.6.1 Frontend: index.html
Im Frontend wird die Eingabe verarbeitet und per fetch-Aufruf an den Server gesendet:
fetch(`/chat?rag=${rag}`, {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ message: userMessage })
});
Die Antwort wird als JSON entgegengenommen und im Chatbereich angezeigt.
6.6.2 Backend: app.py
Das Flask-Backend stellt zwei Routen bereit:
Startseite mit der HTML-Oberfläche:
@app.route("/")
def index():
    return render_template("index.html")
API-Endpunkt für den Chat:
@app.route("/chat", methods=["POST"])
def chat():
    data = request.get_json()
    user_message = data.get("message", "")
    rag_select = request.args.get("rag", "mit")

    script_path = os.path.join(SCRIPTS_DIR, "run_llm.py")

    try:
        result = subprocess.run(
            ["python", script_path, user_message, rag_select],
            text=True,
            capture_output=True,
            check=True,
        )
        output = result.stdout.strip()
    except subprocess.CalledProcessError as e:
        output = f"Fehler beim Ausführen von 'run_llm.py': {e.stderr.strip()}"

    return jsonify({"response": output})
6.6.3 Screenshot der UI
6.6.4 Ganzer Code
index.html:
<!DOCTYPE html>
<html lang="de">
<head>
  <meta charset="UTF-8">
  <title>Randomly Awesome Genius</title>
  <style>
    :root {
      --bg-main: #212121;
      --bg-chat: #202123;
      --bg-user: #323232d9;
      --bg-bot: #323232d9;
      --text: #ffffff;
      --input-bg: #40414f;
      --accent: #10a37f;
    }

    * {
      box-sizing: border-box;
    }

    body {
      margin: 0;
      padding: 0;
      font-family: "Segoe UI", sans-serif;
      background-color: var(--bg-main);
      color: var(--text);
      display: flex;
      flex-direction: column;
      height: 100vh;
    }

    header {
      background-color: var(--bg-chat);
      padding: 16px;
      text-align: center;
      font-size: 18px;
      font-weight: 500;
      border-bottom: 1px solid #2d2f38;
    }

    #chat-box {
      flex: 1;
      padding: 20px;
      overflow-y: auto;
      display: flex;
      flex-direction: column;
      gap: 14px;
    }

    .message {
      max-width: 80%;
      padding: 14px 16px;
      border-radius: 12px;
      font-size: 15px;
      line-height: 1.5;
      white-space: pre-wrap;
    }

    .user {
      align-self: flex-end;
      background-color: var(--bg-user);
      color: #fff;
    }

    .bot {
      align-self: flex-start;
      background-color: var(--bg-bot);
      color: #fff;
    }

    footer {
      display: flex;
      gap: 8px;
      padding: 14px;
      background-color: var(--bg-chat);
      border-top: 1px solid #2d2f38;
    }

    input, select {
      background-color: var(--input-bg);
      color: white;
      border: 1px solid #555;
      border-radius: 8px;
      padding: 10px;
      font-size: 15px;
    }

    input {
      flex: 1;
    }

    select {
      max-width: 160px;
    }

    button {
      background-color: var(--accent);
      color: white;
      border: none;
      padding: 10px 16px;
      font-size: 15px;
      border-radius: 8px;
      cursor: pointer;
      transition: background-color 0.2s ease;
    }

    button:hover {
      background-color: #0e8f70;
    }

    ::placeholder {
      color: #aaa;
    }

    .typing-indicator {
      display: inline-block;
      font-size: 20px;
      line-height: 1;
    }

    .typing-indicator span {
      display: inline-block;
      width: 6px;
      height: 6px;
      margin: 0 2px;
      background: #ccc;
      border-radius: 50%;
      animation: bounce 1.4s infinite ease-in-out both;
    }

    .typing-indicator span:nth-child(2) {
      animation-delay: 0.2s;
    }

    .typing-indicator span:nth-child(3) {
      animation-delay: 0.4s;
    }

    @keyframes bounce {
      0%, 80%, 100% {
        transform: scale(0);
      }
      40% {
        transform: scale(1);
      }
    }
  </style>
</head>
<body>
  <header>Randomly Awesome Genius</header>

  <div id="chat-box"></div>

  <footer>
    <select id="rag-select">
      <option value="ohne">Ohne RAG</option>
      <option value="mit">Mit RAG</option>
    </select>
    <input type="text" id="input" placeholder="Nachricht eingeben..." />
    <button onclick="sendMessage()">Senden</button>
  </footer>

  <script>
    async function sendMessage() {
      const inputField = document.getElementById("input");
      const chatBox = document.getElementById("chat-box");
      const rag = document.getElementById("rag-select").value;
      const userMessage = inputField.value.trim();

      if (!userMessage) return;

      const userDiv = document.createElement("div");
      userDiv.className = "message user";
      userDiv.textContent = userMessage;
      chatBox.appendChild(userDiv);

      inputField.value = "";
      chatBox.scrollTop = chatBox.scrollHeight;

      const loadingDiv = document.createElement("div");
      loadingDiv.className = "message bot";
      loadingDiv.innerHTML = `<div class="typing-indicator"><span></span><span></span><span></span></div>`;
      chatBox.appendChild(loadingDiv);
      chatBox.scrollTop = chatBox.scrollHeight;

      try {
        const res = await fetch(`/chat?rag=${rag}`, {
          method: "POST",
          headers: { "Content-Type": "application/json" },
          body: JSON.stringify({ message: userMessage })
        });

        const data = await res.json();

        chatBox.removeChild(loadingDiv);

        const botDiv = document.createElement("div");
        botDiv.className = "message bot";
        botDiv.textContent = data.response;
        chatBox.appendChild(botDiv);
        chatBox.scrollTop = chatBox.scrollHeight;
      } catch (error) {
        const errorDiv = document.createElement("div");
        errorDiv.className = "message bot";
        errorDiv.textContent = "Fehler beim Abrufen der Antwort: " + error.message;
        chatBox.appendChild(errorDiv);
      }
    }

    document.getElementById("input").addEventListener("keydown", function(e) {
      if (e.key === "Enter") {
        e.preventDefault();
        sendMessage();
      }
    });
  </script>
</body>
</html>app.py:
from flask import Flask, request, jsonify, render_template
import subprocess
import os

app = Flask(__name__)
SCRIPTS_DIR = os.path.join(os.path.dirname(__file__), "scripts")

@app.route("/")
def index():
    return render_template("index.html")

@app.route("/chat", methods=["POST"])
def chat():
    data = request.get_json()
    user_message = data.get("message", "")
    rag_select = request.args.get("rag", "mit")

    script_path = os.path.join(SCRIPTS_DIR, "run_llm.py")

    try:
        result = subprocess.run(
            ["python", script_path, user_message, rag_select],
            text=True,
            capture_output=True,
            check=True,
        )
        output = result.stdout.strip()
    except subprocess.CalledProcessError as e:
        output = f"Fehler beim Ausführen von 'run_llm.py': {e.stderr.strip()}"

    return jsonify({"response": output})

if __name__ == "__main__":
app.run(debug=True)run_llm.py:
# Disclaimer: Alle Print-Ausgaben bis auf die Rückgabe des LLM sind auskommentiert,
# damit der Kontext funktioniert müssen vorher die Artikel geladen werden.
from langchain_chroma import Chroma
from langchain_ollama import ChatOllama
from langchain_ollama import OllamaEmbeddings
from langchain_core.runnables import RunnablePassthrough
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
import ollama
from tqdm import tqdm
import sys

# settings
EMBED_MODEL = 'mxbai-embed-large'
MODEL = 'gemma3:27b'
TOKEN_LIMIT = 1000
TEMP = 0.5

#Downloading models...

models_to_download = [MODEL, EMBED_MODEL]

for model in models_to_download:
    #print(f"-------\nPulling {model}...\n-------")
    bars = {}
    for progress in ollama.pull(model, stream=True):
        digest = progress.get('digest')
        if not digest:
            #print(progress.get('status'))
            continue

        if digest not in bars:
            bars[digest] = tqdm(total=progress.get('total'), desc=f'pulling {digest[7:19]}', unit='B', unit_scale=True)

        #bars[digest].update(progress.get('completed', 0) - bars[digest].n)
        if progress.get('completed') == progress.get('total'):
            bars[digest].close()

# question and context to be embedded
question = sys.argv[1]

# LLM settings
model_local = ChatOllama(
    model=MODEL,
    num_predict=TOKEN_LIMIT,
    temperature=TEMP,
    stream=True,
    stop=[
        "<|start_header_id|>",
        "<|end_header_id|>",
        "<|eot_id|>",
        "<|reserved_special_token",
    ],
)

if (len(sys.argv) > 2 and sys.argv[2] == 'mit'):#Generating answer with RAG...
    print("Antwort mit RAG:\n")
    # load content of vector database
    vectorstore = Chroma(
        persist_directory="./../test_db",
        embedding_function=OllamaEmbeddings(model=EMBED_MODEL),
    )
    retriever = vectorstore.as_retriever()
    after_rag_template = (
        "Beantworte die Frage nur mithilfe des folgenden Kontextes:\n{context}\nFrage: {question}"
    )

    after_rag_prompt = ChatPromptTemplate.from_template(
        template=after_rag_template
    )
    after_rag_chain = (
        {"context": retriever, "question": RunnablePassthrough()}
        | after_rag_prompt
        | model_local
        | StrOutputParser()
    )

    for chunk in after_rag_chain.stream(question):
        print(chunk, end="", flush=True)
else:
    print("Antwort ohne RAG:\n")
    before_rag_template = (
        "Beantworte die folgende Frage"
        + ": {question}"
    )
    before_rag_prompt = ChatPromptTemplate.from_template(
        template=before_rag_template
    )
    before_rag_chain = before_rag_prompt | model_local | StrOutputParser()

    for chunk in before_rag_chain.stream(question):
        print(chunk, end="", flush=True)
print()
6.7 Fazit
Das Projekt zeigt, wie ein LLM durch zusätzliche Informationen aus einer Vektordatenbank verbessert werden kann. Die Technik garantiert allerdings nicht immer eine perfekte Antwort. Das Aufbereiten des verwendeten Kontextes ist hierzu sehr wichtig.
Die Ergänzung um einen Klassifikator erlaubt es dem Model darüber hinaus kontextsensitiv zu reagieren und neue Informationen zu erkennen.